کاهش Latency فایروال سیسکو، در بسیاری از سازمان ها وقتی کاربران از کندی سرویس ها شکایت میکنند، اولین تجهیزی که زیر سؤال میرود فایروال است؛ زیرا تمام Packetها از آن عبور میکنند. اما بررسی مهندسی نشان میدهد کاهش Latency فایروال سیسکو بیش از آنکه به خود دستگاه وابسته باشد، به ساختار Access Control Policy، ترتیب قواعد NAT، دامنه قابلیتهای بازرسی و تطابق ظرفیت سخت افزار با ترافیک واقعی بستگی دارد. تأخیر معمولاً نتیجه طراحی نادرست است، نه صرف وجود فایروال.
این راهنما برای دو سناریو کاربرد دارد: بهبود سرعت فایروال Cisco ASA در محیطهای کلاسیک و رفع کندی فایروال Cisco Secure Firewall در معماریهای نسل جدید. هدف، خاموش کردن کنترلهای امنیتی نیست؛ هدف رسیدن به تنظیمات بهینه فایروال سیسکو است که امنیت عمیق و کارایی بالا را همزمان ممکن میکند و در ادامه، مراحل عملی، پیشنیازها و محدودیتهای آن بررسی میشود.
پیش از هر تغییری، از پیکربندی ASA یا FTD نسخه پشتیبان تهیه کنید و تغییرات را ابتدا در محیط آزمایشی یا در پنجره نگهداری ارزیابی کنید. تمام دستورات این مقاله از نوع نمایش وضعیت و فقط-خواندنی هستند و برای شناخت وضعیت فعلی به کار میروند؛ هیچ تغییر پیکربندی را بدون برنامه بازگشت و ثبت مستندات اعمال نکنید.
نقشهای از مسیر ترافیک داشته باشید و تأخیر را سرتاسری اندازهگیری کنید؛ گاهی عامل تأخیر در تجهیزات بالادست مانند روتر سیسکو یا در وضعیت پورتها و کابلکشی سوییچ شبکه است، نه در خود فایروال. اندازهگیری تأخیر از دو سمت فایروال، سهم واقعی آن را مشخص میکند و مانع از بهینهسازی یک تجهیز بیگناه میشود.
خط پایه اولیه باید این موارد را پوشش دهد:
در Cisco ASA و Cisco Secure Firewall، اولین Packet هر Flow پرهزینهترین مرحله پردازش است. سیستم باید Interface خروجی را بر اساس جدول مسیریابی تعیین کند، NAT را ارزیابی کند، مجاز بودن Flow را با Access Control Policy بررسی کند و سپس Session را در Connection Table ثبت نماید. اگر Intrusion Policy یا SSL Decryption فعال باشد، هزینه این مرحله بهطور چشمگیری افزایش مییابد.
Packetهای بعدی همان Session این مسیر کامل را طی نمیکنند و مستقیماً با جدول اتصال تطبیق داده میشوند؛ بنابراین هرچه تعداد Sessionهای کوتاهمدت بیشتر باشد، سهم First Packetها از بار پردازش بالاتر میرود. ترافیک API Callها، ارتباط میکروسرویسها و وب با Sessionهای کوتاه دقیقاً از همین الگو متأثر میشوند و تأخیر خود را در ساعات اوج نشان میدهند.
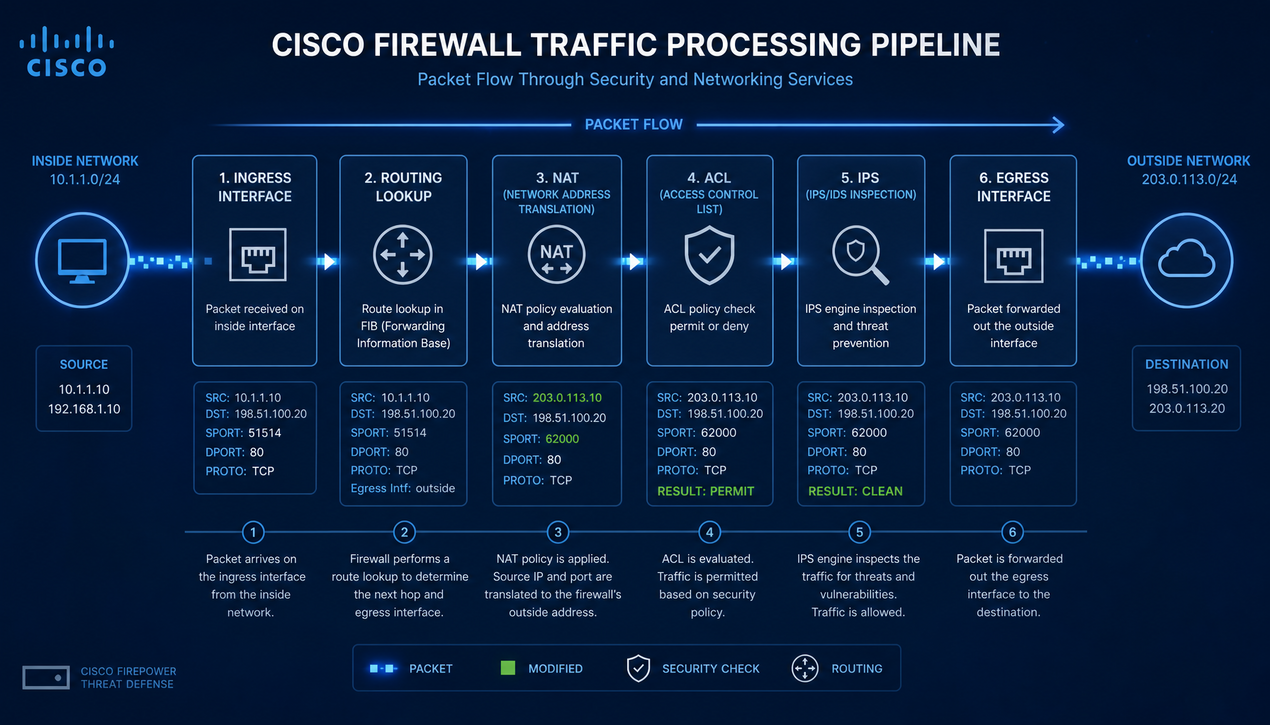
بعد از NAT، دو مرحله سنگین دیگر وجود دارد: Intrusion Inspection که در آن Packet با Signatureهای سیاست بازرسی تطبیق داده میشود، و SSL Decryption که مدیریت مذاکره TLS، بررسی زنجیره Certificate و رمزگشایی و رمزگذاری مجدد را به فایروال تحمیل میکند. Logging بیش از حد نیز با تولید حجم بالای Event و فشار I/O، به شکل غیرمستقیم کارایی را پایین میآورد.
در ASA، پر شدن Connection Table یا افزایش ناگهانی اتصالهای نیمهباز (Embryonic) نیز میتواند به Drop یا افزایش تأخیر منجر شود؛ سناریویی که در حملات SYN Flood دیده میشود و کاربران واقعی را هم متأثر میکند. به همین دلیل پایش این جدول، بخش جداییناپذیر فرایند بهینهسازی است.
ارزیابی Policy بهصورت Top-Down انجام میشود؛ یعنی هر Packet از اولین Rule شروع میکند و تا رسیدن به اولین تطبیق به پایین حرکت میکند. اگر Rule پرترافیک در انتهای Policy قرار داشته باشد، تمام Flowهای مربوط به آن باید تعداد زیادی Rule کمکاربرد را بررسی کنند. در مقیاس هزاران Session در ثانیه، این هزینه کوچک به تأخیر تجمعی و محسوس تبدیل میشود.
نقطه شروع بازطراحی، تحلیل Hit Count واقعی است، نه تصور از پرترافیکترین Ruleها. در ASA تعداد تطبیق هر خط ACL در خروجی دستور show access-list با فیلد hitcnt نمایش داده میشود و در FMC نیز ویرایشگر Access Control Policy تعداد تطبیق را برای هر Rule نشان میدهد. بر اساس این داده، Ruleهای پرترافیک را به ابتدای Policy منتقل کنید تا مسیر اکثر Flowها کوتاه شود.
گام بعدی، ادغام Ruleهای تکراری و تقریباً یکسان است. اگر چند Rule فقط در یک Subnet یا Service تفاوت داشته باشند، تجمیع آنها در قالب Object Group هم Policy را خواناتر میکند و هم تعداد ارزیابی هر Packet را کاهش میدهد. Ruleهای بسیار پیچیده با شرطهای همزمان Application و User را فقط برای ترافیک خاص نگه دارید و برای ترافیک عمومی از قواعد ساده استفاده کنید.
قواعد NAT همپوشان و عمومی یکی از نقاط پنهان تأخیر هستند. اگر یک Flow جدید مجبور شود چندین قاعده را بررسی کند تا Match پیدا کند، این هزینه در مقیاس هزاران اتصال در ثانیه به تأخیر ایجاد Session تبدیل میشود. طراحی قواعد خاص، بدون همپوشانی و با ترتیب منطقی، هزینه Lookup را کاهش میدهد و رفتار Policy را قابل پیشبینی میکند.
در ASA، ارزیابی NAT در بخشهای مشخص و با ترتیب از پیش تعیینشده انجام میشود: ابتدا Manual NAT، سپس Object NAT و در نهایت قواعد Manual NAT از نوع after-auto. آگاهی از این ترتیب برای پیشبینی اینکه کدام قاعده زودتر Match میشود ضروری است؛ در غیر این صورت ممکن است قاعدهای که تصور میکنید فعال است، عملاً هرگز ارزیابی نشود. برای بازرسی تعداد تطبیق هر قاعده، دستور show nat detail در ASA کمک میکند قواعد بیاستفاده یا تداخلدار را شناسایی و حذف کنید.
Intrusion Policy یکی از سنگینترین مؤلفههای پردازشی است و باید بر اساس Zone و سطح ریسک اعمال شود، نه بهصورت یکنواخت روی کل ترافیک. در Cisco Secure Firewall، موتور بازرسی (Snort) هر Packet ورودی را با Signatureهای سیاست تطبیق میدهد؛ هرچه سیاست شامل قواعد بیشتری باشد، عمق پردازش بیشتر و هزینه هر Flow بالاتر است.
یک رویکرد عملی، اعمال سیاست بازرسی کامل روی ترافیک اینترنت و DMZ و اعمال سیاست سبکتر روی ترافیک داخلی کنترلشده مانند ارتباط کاربران با سرور فایل است. این انتخاب باید مستند و مبتنی بر تحلیل ریسک باشد؛ معافسازی از بازرسی یک تصمیم امنیتی است، نه یک تنظیم صرفاً فنی، و باید شفاف، موقت یا قابل دفاع باشد.
SSL Decryption بیشترین فشار را به CPU وارد میکند، زیرا فایروال در نقش یک Man-in-the-Middle کنترلشده باید مذاکره TLS را مدیریت کند، زنجیره Certificate را بررسی نماید، گواهی موقت تولید کند و سپس رمزگشایی و رمزگذاری مجدد انجام دهد. اگر نرخ Handshakeهای همزمان در ساعات اوج بالا برود، تأخیر به شکل محسوس در پاسخ سرویسها دیده میشود، حتی وقتی پهنای باند آزاد به نظر میرسد.
اصل مهندسی در این بخش Risk-Based Decryption است: رمزگشایی فقط جایی انجام شود که ارزش امنیتی آن از هزینه پردازشی بیشتر باشد. دستههای کمریسک و پرحجم مانند سرویسهای SaaS شناختهشده گزینه نخست معافسازی هستند و تمرکز باید روی دستههای پرریسک بماند؛ دستههایی مانند بانکی و سلامت نیز به دلایل انطباق معمولاً از رمزگشایی خارج میشوند. در ظرفیتسنجی، نسبت ترافیک رمزگشاییشده را جداگانه تخمین بزنید، زیرا ظرفیت Decryption هر مدل با ظرفیت بازرسی ساده تفاوت چشمگیری دارد.
Logging بیش از حد به شکل غیرمستقیم Performance را تحت تأثیر قرار میدهد. ثبت رویداد پایان Connection برای Rule عمومی اینترنت، در سازمانهای متوسط حجم بسیار بالایی Event تولید میکند؛ این حجم هم فشار I/O فایروال را بالا میبرد و هم جمعکننده لاگ مانند Syslog Server یا SIEM را درگیر میکند و در بار سنگین ممکن است صف پردازش رویداد شکل بگیرد.
ثبت لاگ را هدفمند کنید: رویدادهای Deny و Ruleهای حساس باید ثبت شوند، اما ترافیک عمومی پرحجم نیازی به Logging دائمی ندارد مگر برای تحلیل خاص و مقطعی. در ASA میتوان رفتار ثبت رویداد را در سطح هر خط ACL تعریف کرد و در FMC این تفکیک در تنظیمات Logging هر Rule انجام میشود؛ نتیجه، کاهش بار پردازشی بدون از دست رفتن ردپایی از رویدادهای مهم است.
انتخاب مدل صرفاً بر اساس عدد Throughput دیتاشیت، یک خطای رایج ظرفیتسنجی است؛ این اعداد معمولاً در شرایط ایدهآل و بدون فعال بودن همزمان IPS، SSL Decryption و قابلیتهای لایه 7 ارائه میشوند. با فعال شدن این قابلیتها، ظرفیت واقعی میتواند به کسری چشمگیر از عدد اعلامشده برسد و مدل انتخابی در ساعات اوج دچار اشباع شود.
پیش از انتخاب یا ارتقا، Baseline ترافیک را تحلیل کنید: پهنای باند واقعی، نرخ اتصال جدید، نسبت ترافیک رمزگشاییشده و پیشبینی رشد در بازههای آتی. سپس مدل را با پیشرفت قابلیتهای همزمان مقایسه کنید. برای بررسی مدلها، مشخصات فنی و مقایسه گزینههای موجود، میتوانید صفحه
فایروال سیسکو را مطالعه کنید و اگر CPU در ساعات اوج بهطور پایدار اشباع میشود، بهینهسازی Policy فقط تأخیر را کمی کاهش میدهد و راه پایدار، ارتقای سختافزار یا بازتوزیع ترافیک است.
اگر تمام ترافیک در یک Zone بزرگ قرار گیرد، فایروال ناچار است یک سطح بازرسی یکسان روی همه آن اعمال کند. با Segmentation منطقی، ترافیک کمریسک را میتوان از بازرسی سنگین معاف کرد بدون آنکه مسیرهای پرریسک بدون کنترل بمانند؛ نتیجه، کاهش بار پردازشی همراه با افزایش دقت کنترلها است.
به عنوان مثال، ترافیک بین سرورهای داخلی که در یک Zone امن قرار دارند را میتوان با سیاست بازرسی سبکتر عبور داد و تمام ترافیک اینترنتی را تحت کنترل کامل نگه داشت. Segmentation درست همزمان دو نتیجه دارد: کاهش پردازش غیرضروری روی Flowهای کمریسک و محدود شدن دامنه حرکت یک تهدید در صورت نفوذ.
بهینهسازی یک اقدام مقطعی نیست؛ شاخصهای کلیدی باید بهصورت دورهای پایش شوند تا روندهای افزایشی پیش از رسیدن به نقطه اشباع شناسایی شوند. مهمترین شاخصها عبارتاند از مصرف CPU و Memory، تعداد اتصالهای همزمان نسبت به سقف، نرخ Session جدید، تعداد تطبیق قواعد و خطاها و Dropهای اینترفیس. خروجی این پایش، مبنای تصمیمهای بعدی است.
دستورات زیر همگی از نوع نمایش وضعیت هستند، پیکربندی را تغییر نمیدهند و در Cisco ASA برای جمعآوری خط پایه منابع استفاده میشوند. خروجی آنها را در ساعات اوج و کمبار ثبت کنید و روند تغییرات را با هم مقایسه نمایید تا رفتار سیستم در برابر بار واقعی مشخص شود:
در تفسیر خروجی، به چند نشانه دقت کنید: نزدیک شدن تعداد اتصالها به سقف مجاز، افزایش مقدار MISS در خروجی show blocks که نشانه کمبود بافر است، خطاهای اینترفیس و صفهای ارسال پر، و CPU پایدار در سطح بالا در ساعات اوج. هر یک از این موارد میتواند توضیحدهنده تأخیر باشد حتی وقتی پهنای باند آزاد به نظر میرسد.
برای تحلیل زمان Match قواعد، رفتار NAT و آمار بازرسی، دستورات بازرسی زیر در ASA کاربرد دارند. توجه داشته باشید نمایش آمار Threat Detection به فعال بودن این قابلیت روی تجهیز وابسته است:
در استقرارهای Cisco Secure Firewall که مدیریت از طریق FMC انجام میشود، همین دادهها از مسیرهای گرافیکی قابل مشاهده است: در FMC از بخش Health میتوان شاخصهای CPU، Memory و Connection هر Device را بهصورت زمانی پایش کرد و در ویرایشگر Access Control Policy تعداد تطبیق هر Rule در جدول Ruleها نمایش داده میشود. در ASDM نیز بخش Monitoring نمودارهای CPU و Connection را ارائه میدهد.
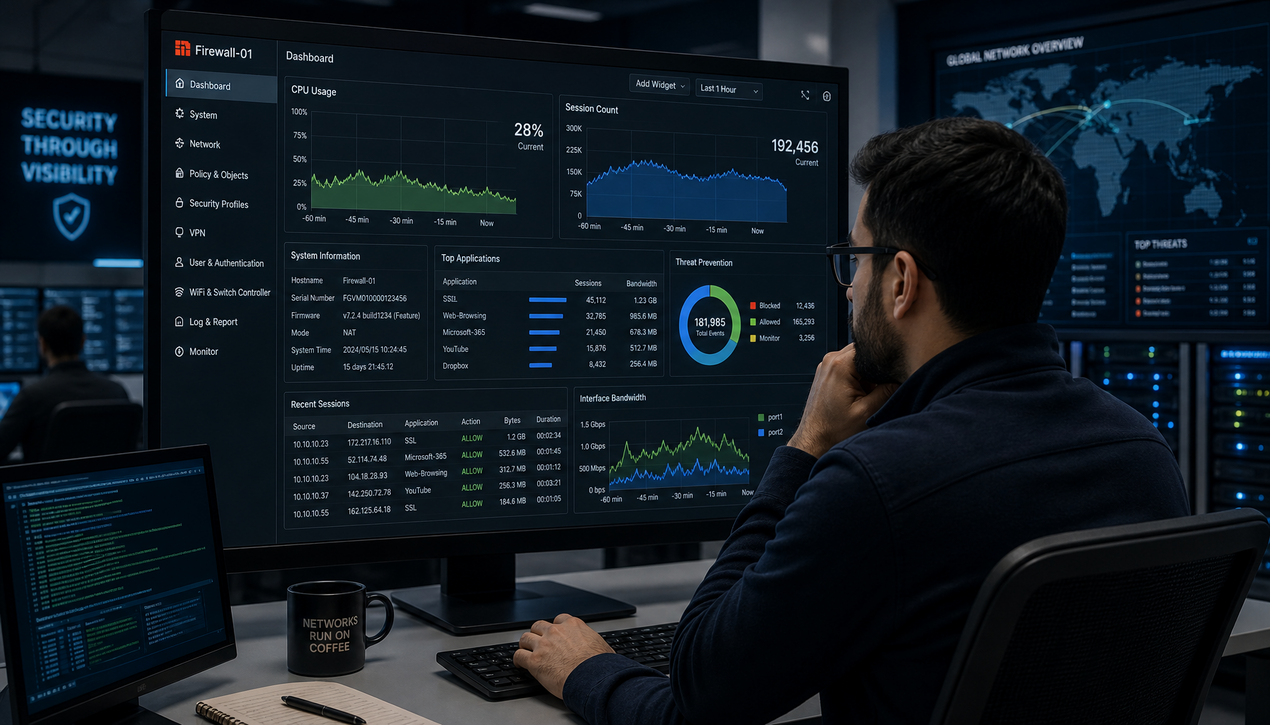
بهینهسازی نمیتواند محدودیت سختافزاری را جبران کند. اگر ظرفیت پردازش با ترافیک رمزگشاییشده و بازرسی عمیق همزمان جوابگو نباشد، تغییر تنظیمات فقط تأخیر را جابهجا میکند و راهحل پایدار، ارتقای مدل یا بازتوزیع ترافیک است. پیش از هر تصمیمی، سهم هر قابلیت را با ارزیابی کنترلشده در محیط آزمایشی بسنجید و نتیجه را مستند کنید.
هر معافسازی از بازرسی، تغییر در وضعیت امنیتی است و باید مبتنی بر تحلیل ریسک، مستند و قابل بازگشت باشد. پس از اعمال تغییرات، مطمئن شوید سطح امنیتی مسیرهای جدید افت نکرده است؛ برای ساختارمند کردن ارزیابیهای امنیتی پس از بهینهسازی میتوانید از
راهنمای رسمی OWASP برای ارزیابی امنیت برنامههای وب بهعنوان مرجع تست استفاده کنید.
در نهایت، Latency لزوماً از فایروال نیست: کیفیت لینک WAN، مسیریابی غیربهینه، اشکال در سرور مقصد یا حتی مشکل DNS میتواند عامل تأخیر باشد. اندازهگیری تأخیر از دو سمت فایروال و مقایسه نتایج، سادهترین راه تفکیک این حالتهاست؛ بدون این داده، بهینهسازی Policy ممکن است بدون نتیجه بماند.
خیر. حذف کامل IPS سطح امنیتی را به شکل خطرناکی پایین میآورد. رویکرد درست، اعمال سیاست بازرسی بر اساس Zone و ریسک است: بازرسی کامل برای ترافیک اینترنت و DMZ و سیاست سبکتر برای ترافیک داخلی کنترلشده. به این ترتیب بخش عمده تأخیر غیرضروری حذف میشود بدون آنکه مسیرهای پرریسک بدون دفاع بمانند.
مصرف CPU و Memory، تعداد اتصالهای همزمان نسبت به سقف، تعداد تطبیق قواعد ACL یا Access Rule، خطا و Drop اینترفیس و مقدار MISS در Blocks. اگر CPU در ساعات اوج پایدار بالاست و اتصالها به سقف نزدیک میشوند، مشکل ظرفیت است؛ اگر CPU پایین است و تأخیر وجود دارد، به ترتیب قواعد و مسیرهای بالادست شک کنید.
نه. تأخیر میتواند از لینک WAN، مسیریابی، DNS یا سرور مقصد باشد. با اندازهگیری تأخیر از دو سمت فایروال و مقایسه نتایج، سهم فایروال مشخص میشود و این تست را در ساعات مختلف تکرار کنید تا الگوی زمانی مشکل شفاف شود. تنها وقتی اختلاف معنادار بین دو سمت دیده شد، تمرکز روی Policy و ظرفیت فایروال منطقی است.
کاهش Latency فایروال سیسکو به معنای خاموش کردن قابلیتهای امنیتی نیست؛ به معنای طراحی هدفمند و مبتنی بر داده است. چهار ستون پایداری Performance عبارتاند از طراحی و مرتبسازی درست Access Control Policy و NAT، اعمال رویکرد Risk-Based برای IPS و SSL Decryption، Logging کنترلشده و انتخاب سختافزار متناسب با ترافیک واقعی سازمان.
بهینه سازی Performance فایروال سیسکو یک فرایند مستمر است: خط پایه بگیرید، تغییر را کوچک و مستند اعمال کنید، اثر آن را بسنجید و نتیجه را در چرخه بعدی به کار ببرید. بدون بازنگری دورهای، Policyها به مرور دچار انحراف میشوند و تأخیر بازمیگردد؛ همین چرخه ساده، تفاوت میان یک زیرساخت پایدار و یک مجموعه تنظیمات فرسوده است.
وینو سرور با تمرکز بر زیرساختهای مبتنی بر Cisco ASA و Cisco Secure Firewall، در طراحی، بازبینی و بهینهسازی سیاستهای امنیتی همراه شماست؛ از تحلیل خط پایه ترافیک تا انتخاب مدل مناسب و بازطراحی Policy. اگر به دنبال تعادل واقعی بین امنیت و کارایی در مقیاس سازمانی هستید، تیم وینو سرور میتواند مسیر اجرای این راهنما را با شما طی کند.