بررسی سلامت هارد سرور یکی از مهمترین بخشهای نگهداری پیشگیرانه در زیرساختهای IT است. یک دیسک معیوب در حال کار میتواند بدون هیچ هشدار واضحی به توقف کامل سرویس منجر شود، خصوصاً اگر آرایه RAID در وضعیت Degraded قرار گرفته باشد. در این مقاله شاخصهای کلیدی سلامت، ابزارهای تست هارد سرور، روشهای پایش و نکات تصمیمگیری برای تعویض پیشگیرانه دیسک را بررسی میکنیم.
بررسی سلامت هارد سرور برای جلوگیری از Downtime ناگهانی، از دست رفتن داده و تخریب آرایه RAID ضروری است و بخشی از استراتژی نگهداری پیشگیرانه محسوب میشود. در محیطهای Production، خرابی یک دیسک میتواند به توقف کامل سرویس منجر شود، خصوصاً اگر RAID در وضعیت Degraded باشد و دیسک دوم آرایه نیز در آستانه خرابی قرار داشته باشد.
نکتهای که در پروژههای عملی با سرورهای Hewlett Packard Enterprise مشاهده میشود این است که سیستمها گاهی تا لحظه آخر وضعیت OK نمایش میدهند. تنها تحلیل روند افزایش خطاها در طول چند هفته است که نشان میدهد دیسک در آستانه خرابی قرار دارد. اتکا به وضعیت ظاهری سیستم بدون تحلیل لاگ، رویکردی پرریسک در محیطهای حساس است.
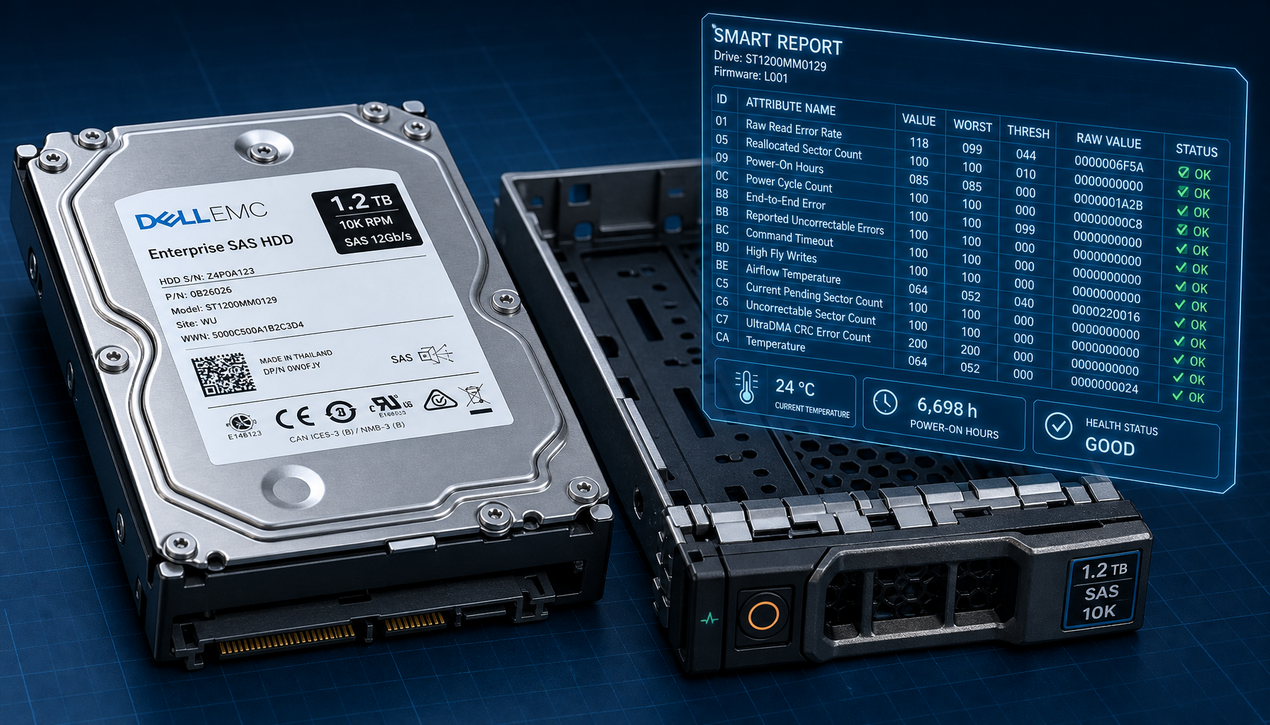
برای تشخیص خرابی هارد سرور باید شاخصهایی مانند SMART Attributes، Current Pending Sector Count، Reallocated Sector Count، Temperature و Error Rate بررسی شوند تا روند فرسودگی دیسک مشخص گردد. این شاخصها معمولاً از طریق کنترلر RAID یا ابزارهای مانیتورینگ قابل مشاهده هستند و مهمتر از مقادیر لحظهای، روند تغییرات آنها است.
سلامت هارد تنها به سکتور معیوب محدود نمیشود؛ شرایط محیطی مانند دما و جریان هوای رک نیز اهمیت زیادی دارند. افزایش دمای مداوم یک دیسک میتواند افت Performance و تسریع فرسودگی ایجاد کند. در پروژههای عملی، اصلاح تهویه رک گاهی بدون تغییر هیچ دیسکی، Latency را به حالت عادی بازگردانده است.
ابزار تست هارد سرور بسته به برند سرور و نوع کنترلر RAID متفاوت است. در سرورهای HPE ابزارهایی مانند HPE Smart Storage Administrator و iLO برای مشاهده وضعیت دیسکها و اجرای دیاگنوستیک استفاده میشوند. در لینوکس ابزار smartctl (بسته smartmontools) استاندارد de facto برای خواندن اطلاعات SMART است.
تست نرمافزاری باید بهصورت دورهای انجام شود، نه فقط هنگام بروز خطا. برای سازمانهایی که قصد ارتقای زیرساخت ذخیرهسازی دارند، انتخاب هارد سازگار با کنترلر RAID و فرمفکتور سرور اهمیت زیادی دارد. برای اطلاع از گزینههای موجود میتوانید صفحات
خرید هارد سرور اچپی با گارانتی و هارد استوریج اچپی را بررسی کنید.
اگر از استوریجهای Dell EMC استفاده میکنید، صفحات هارد استوریج EMC
فهرست هاردهای سازگار با این پلتفرم را در اختیار شما میگذارد. در محیطهای ویندوز سرور، ابزارهای گرافیکی کنترلر RAID نیز همان اطلاعات Error Log و Power-On Hours را بهصورت بصری نمایش میدهند.
ابزار smartctl تنها دستور read-only و بدون تاثیر بر داده است و در اکثر توزیعهای لینوکس قابل استفاده است. نمونه دستورهای پایه برای پایش سلامت هارد سرور:
این دستورها را میتوان در محیط تست و با دسترسی root اجرا کرد. توجه کنید که برای دیسکهای پشت کنترلر RAID ممکن است نیاز به ماژول یا ابزار مخصوص کنترلر (مانند HPE ssacli یا معادل آن) باشد تا اطلاعات SMART از طریق کنترلر خوانده شود.
همچنین برای مطالعه جامعتر ابزارها و روشها، مقاله سلامت هارد سرور؛ 7 روش تست و پایش دقیق در وبلاگ وینو سرور منبع مفیدی است.
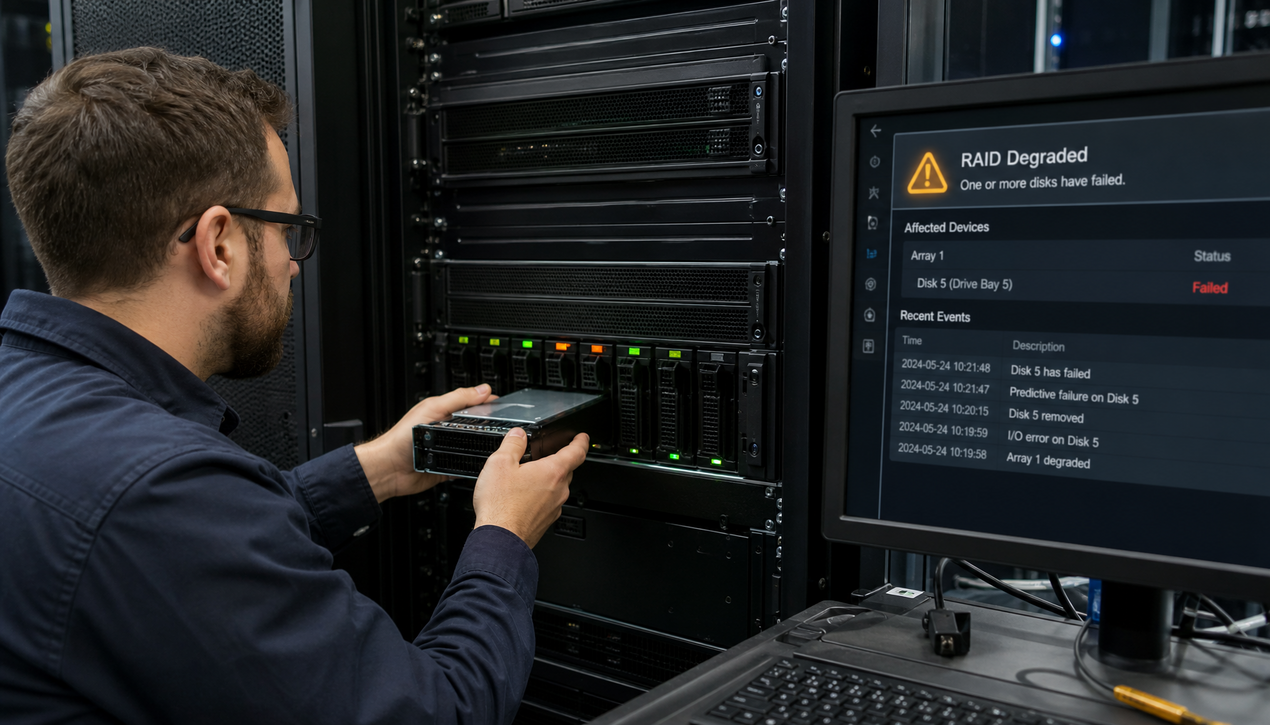
علاوه بر SMART، تست عملی IOPS و Latency برای ارزیابی سلامت واقعی دیسک ضروری است، زیرا برخی خرابیها تنها در بار کاری مشخص میشوند. تستهای Benchmark میتوانند افت عملکرد پنهان را آشکار کنند؛ دیسکی که در تست SMART سالم به نظر میرسد ممکن است در بار I/O سنگین Latency غیرعادی نشان دهد.
پایش در سطح سیستمعامل نیز مکمل این تست است. شاخصهایی مانند طول صف I/O و زمان انتظار دیسک (await در خروجی iostat در لینوکس) نشان میدهند کدام دیسک در آرایه گلوگاه است. ترکیب تست عملی و مانیتورینگ نرمافزاری، دقیقترین تصویر از سلامت دیسک ارائه میدهد.
در یک سازمان مالی، آرایه RAID5 شامل 6 دیسک SAS بود. یکی از دیسکها هشدار Reallocated Sector افزایشیابنده داشت و پیشنهاد شد دیسک قبل از Fail کامل تعویض شود. چند روز بعد، دیسک دوم نیز خطای مشابه نشان داد. اگر دیسک اول تعویض نشده بود، با خرابی دیسک دوم، احتمال از دست رفتن کامل آرایه وجود داشت. در RAID5، تأخیر در تعویض دیسک معیوب ریسک جدی ایجاد میکند.
در پروژهای دیگر، هشدار SMART موقتی باعث نگرانی تیم شد. پس از بررسی دقیق Error Log مشخص شد خطا ناشی از قطع برق لحظهای بوده و سکتور معیوب پایدار وجود ندارد. دیسک تحت نظر قرار گرفت و نیازی به تعویض فوری نبود. این تجربه نشان داد هر هشدار به معنای تعویض فوری نیست؛ تحلیل روند و Context عملیاتی اهمیت دارد.
تست سلامت SSD با HDD متفاوت است، زیرا شاخصهایی مانند Wear Leveling Count و TBW در SSD اهمیت دارند، در حالی که در HDD تمرکز اصلی بر سکتورهای معیوب است. نکته مهمتر اینکه SSD ممکن است بدون هشدار سنتی و بهصورت ناگهانی Fail شود؛ بنابراین تحلیل Endurance در SSD اهمیت ویژهای دارد.
در پروژهای با SSD Enterprise، درصد Wear به 90 درصد رسیده بود اما هنوز خطای جدی گزارش نشده بود. بر اساس سیاست نگهداری پیشگیرانه، دیسک پیش از رسیدن به آستانه خرابی تعویض شد. این رویکرد در محیطهای Production توصیه میشود.
بهترین روش برای حفظ سلامت هارد سرور، پایش سلامت هارد بهصورت مداوم، تعریف Threshold هشدار و اجرای سیاست تعویض پیشگیرانه است. اتکا به واکنش پس از خرابی رویکردی پرریسک است، زیرا خطا ممکن است هفتهها بدون مشاهده باقی بماند.
در پروژههای عملی، تنظیم هشدار ایمیلی برای رویدادهای RAID باعث شده دیسک معیوب در همان روز شناسایی و تعویض شود. پایش دیسک تنها در محیط ذخیرهسازی محدود نمیشود و باید در فاز طراحی امنیت زیرساخت نیز لحاظ شود؛ برای این موضوع میتوانید از منابع معتبری مانند
راهنمای رسمی OWASP برای ارزیابی امنیت برنامههای وب نیز استفاده کنید.
آیا SMART سالم به معنی سلامت کامل دیسک است؟ نه. برخی خرابیها تنها در بار کاری سنگین یا در لاگ کنترلر RAID ظاهر میشوند. ترکیب SMART، لاگ RAID و تست عملی Latency تصویر دقیقی ارائه میدهد.
چند Reallocated Sector برای تعویض دیسک کافی است؟ عدد مطلق مهم نیست؛ روند افزایش آن اهمیت دارد. افزایش پیوسته Reallocated یا Pending Sector طی چند روز، نشانه پیشخرابی است و تعویض پیشگیرانه توصیه میشود.
آیا تست هارد سرور باید دورهای انجام شود؟ بله. پایش سلامت هارد باید بهصورت مداوم و خودکار انجام شود و لاگها بهصورت دورهای بررسی شوند، نه فقط هنگام بروز خطا.
بررسی سلامت هارد سرور ترکیبی از تحلیل SMART، تست عملی Performance، پایش دما و بررسی لاگ RAID است و باید بهصورت دورهای انجام شود تا از Downtime ناگهانی جلوگیری گردد. تشخیص خرابی هارد سرور باید بر اساس تحلیل روند خطاها و ریسک آرایه RAID انجام شود، نه صرفاً یک هشدار موقتی.
اگر برای تحلیل سلامت هارد سرور، طراحی سیاست نگهداری پیشگیرانه یا ارتقای زیرساخت ذخیرهسازی نیاز به بررسی تخصصی دارید، وینو سرور با تجربه پروژههای عملی در حوزه سرور و استوریج میتواند راهکار مهندسیشده و متناسب با نیاز واقعی سازمان شما ارائه دهد تا از دادههای حیاتی خود با اطمینان محافظت کنید.