Replication در استوریج HPE یعنی کپیکردن خودکار دادهها بین دو آرایه استوریج بهصورت همزمان (Sync) یا غیرهمزمان (Async) تا در صورت خرابی سایت اصلی، سرویسها با حداقل RPO و RTO روی سایت دوم بالا بیایند. این مکانیزم در سطح بلاک و داخل خود آرایه انجام میشود، مستقل از سرور و Hypervisor است و معمولاً از طریق FC یا iSCSI روی شبکه SAN پیادهسازی میگردد. برای انتخاب درست حالت Sync یا Async، معیار اصلی Latency لینک و نیاز کسبوکار به RPO است. اگر به دنبال تجهیزات مناسب هستید، صفحات خرید استوریج HP و استوریج SAN اچ پی مرور کاملی از گزینههای موجود ارائه میدهند.
Replication یک فناوری انتقال داده در سطح بلاک بین دو استوریج است که هدف آن تضمین تداوم سرویس، کاهش Downtime و جلوگیری از از دست رفتن اطلاعات در زمان خرابی سایت یا تجهیزات است. در معماری مدرن دیتاسنتر، بکاپ بهتنهایی کافی نیست، زیرا بازیابی از Backup معمولاً ساعتها طول میکشد؛ در حالی که Replication اجازه میدهد یک کپی زنده یا نزدیک به زنده از Volumeها در سایت ثانویه همیشه موجود باشد. وقتی دیتابیس مالی یا سیستم ERP از کار بیفتد، Restore از بکاپ عملاً قابل قبول نیست.
از دیدگاه مفهومی، Replication استوریج همان Mirroring داده در فواصل طولانی است و بسته به فناوری مورد استفاده میتواند بهصورت Synchronous، Asynchronous یا بر اساس Point-in-Time انجام شود. تفاوت کلیدی Replication با Backup در همین نکته است: در بکاپ، نسخه ذخیرهشده مدت طولانی بدون تغییر باقی میماند، اما Replica همواره در حال بهروزرسانی است و وضعیت لحظهای داده را دنبال میکند. به همین دلیل Replication پایه اصلی RPO پایین و RTO سریع است و بدون آن هیچ طراحی Disaster Recovery حرفهای کامل محسوب نمیشود.
در استوریجهای HPE، Replication در سطح بلاک و داخل خود آرایه انجام میشود و وابسته به CPU سرور یا Hypervisor نیست. این ویژگی باعث میشود عملکرد پایدار باشد و فشار پردازشی کاملاً از هاست برداشته شود (Offload). برای آشنایی با تفاوتهای خانوادههای مختلف، مقاله مقایسه استوریجهای MSA، 3PAR و Nimble مرجع خوبی است، زیرا قابلیتهای Replication در این سریها با هم تفاوت دارند.
در سریهای سازمانی مانند 3PAR، Primera و Alletra، موتور Replication با استفاده از Change Tracking فقط بلوکهای تغییر یافته را ارسال میکند، نه کل Volume را؛ بنابراین پهنای باند بهینه مصرف میشود. برای درک اهمیت این موضوع، یک Volume یک ترابایتی با تغییر روزانه 5 درصد را در نظر بگیرید: در هر دوره همگامسازی عملاً تنها حدود 50 گیگابایت داده منتقل میشود. این فرایند از طریق FC، iSCSI و حتی IP WAN قابل انجام است.
مزیت اصلی این معماری آن است که Replication کاملاً Application-Agnostic است؛ چه VMware داشته باشید چه دیتابیس فیزیکی، مکانیزم یکسان کار میکند. به همین دلیل در پروژههای Enterprise ترجیح معمولاً این است که Replication در لایه Storage انجام شود نه بهصورت نرمافزاری روی سرور. البته توجه داشته باشید که قابلیتهای پیشرفته Replication در برخی مدلها به لایسنس و سطح تراشو ارتقا نرمافزاری وابسته است و این موضوع را باید در مرحله خرید بررسی کنید.
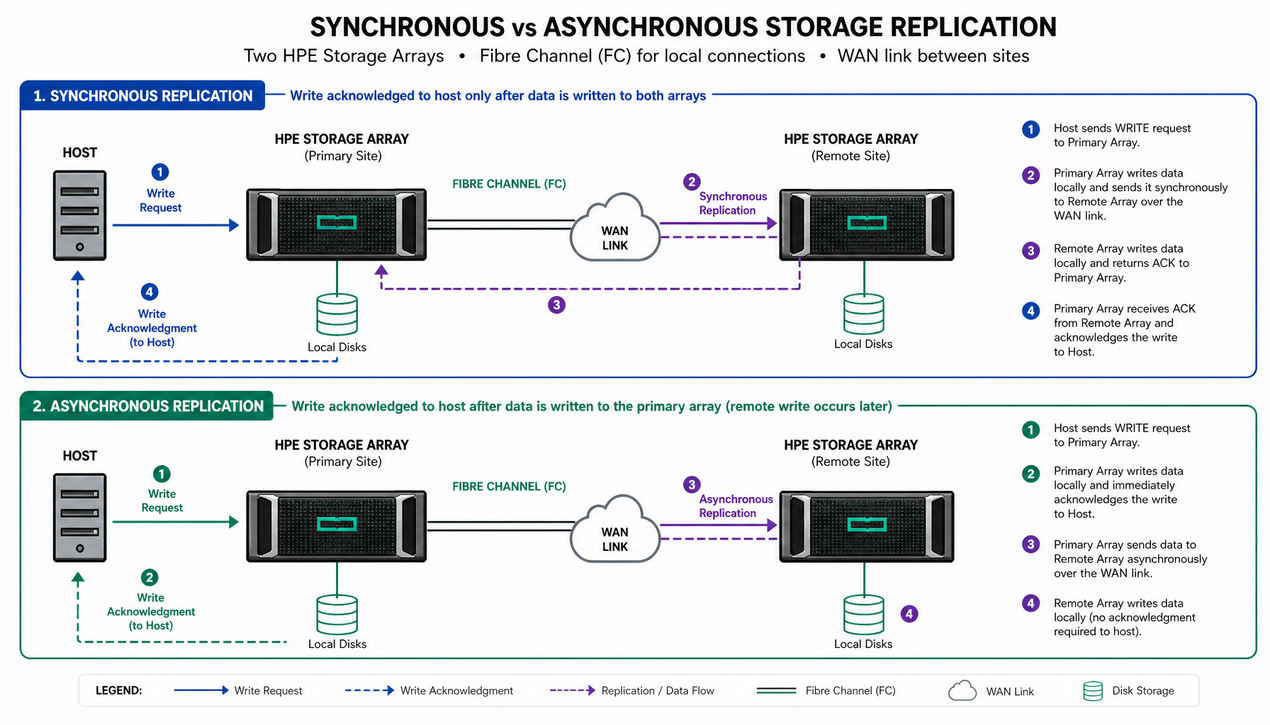
Replication همزمان به این معناست که عمل نوشتن داده تا زمانی که سایت مقصد نیز آن را تأیید نکرده، کامل نمیشود؛ در حالی که Async داده را با تأخیر زمانی منتقل میکند. Sync بهترین RPO ممکن یعنی صفر را ارائه میدهد، اما به Latency بسیار پایین نیاز دارد؛ معمولاً در محدوده 2 تا 3 میلیثانیه. بنابراین فقط برای سایتهای مترو یا Campus با فاصله کم مناسب است. در مقابل، Async اجازه میدهد تغییرات در بازههای چند ثانیهای یا چند دقیقهای منتقل شوند و برای لینکهای WAN بینشهری ایدهآل است.
یک مثال ملموس: در دو سایت با فاصله 30 کیلومتر و فیبر نوری با کیفیت مناسب، Sync قابل اجراست؛ اما با فاصله 400 کیلومتر، Latency لینک به حدی بالا میرود که Sync عملاً Performance نوشتن را نابود میکند و Async تنها گزینه منطقی است. انتخاب اشتباه بین این دو باعث افت شدید Performance یا از دست رفتن داده میشود؛ بنابراین معیار تصمیمگیری باید Latency واقعی لینک و نیاز کسبوکار به RPO باشد، نه صرفاً «جدیترین تکنولوژی».
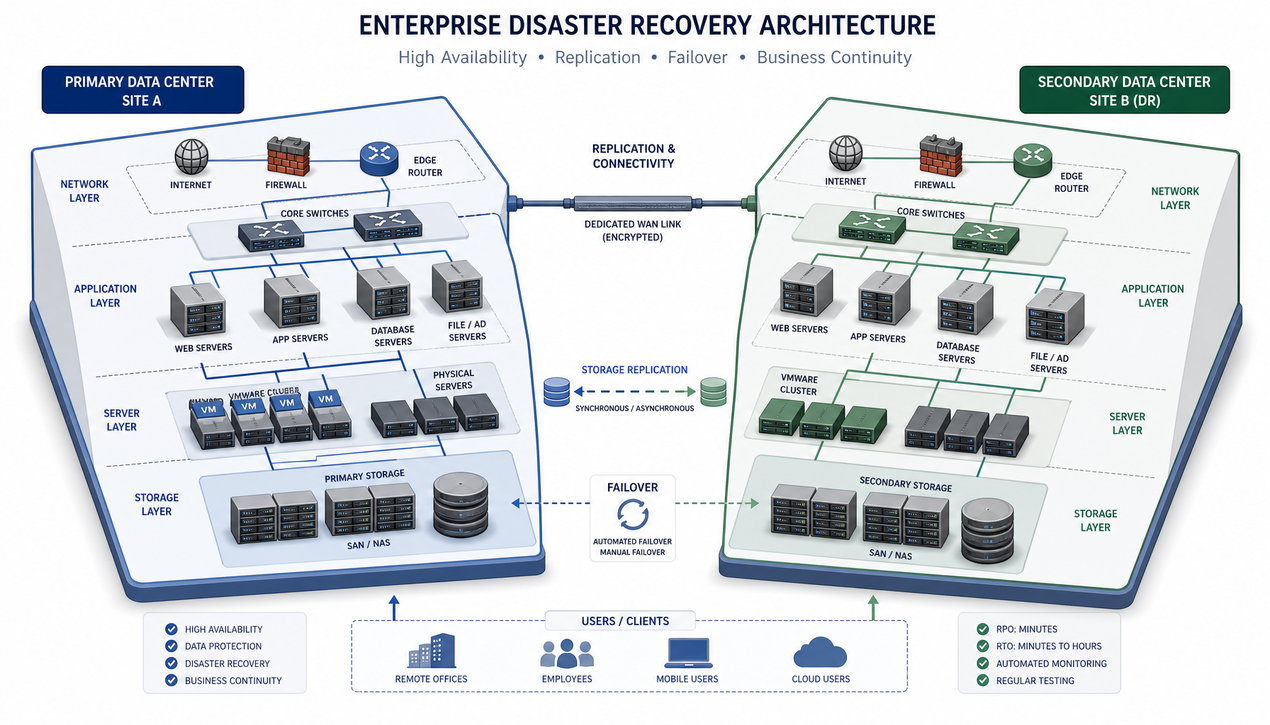
Replication ستون اصلی طراحی DR است، زیرا امکان Failover سریع بدون نیاز به Restore را فراهم میکند. وقتی سایت اصلی از کار میافتد، Volume مقصد Promote میشود و سرویسها بلافاصله روی سایت دوم بالا میآیند؛ این فرآیند بهجای ساعتها، در چند دقیقه انجام میشود. در سناریوی قطع کامل برق سایت اصلی با Replication Async، فقط چند ده ثانیه آخرین تغییرات از دست میرود و کل سرویس ظرف چند دقیقه بازمیگردد؛ در حالی که با بکاپ سنتی، حداقل چند ساعت توقف قابل پیشبینی است.
اما Replication بهتنهایی یک معماری کامل نیست. رویکرد استاندارد در دیتاسنترهای Tier 3 و بالاتر، ترکیب سه لایه حفاظت است: Snapshot برای بازگشت سریع به لحظهای در گذشته، Replication برای بقا در خرابی کل سایت، و Backup برای نگهداری تاریخچه بلندمدت. برای آشنایی با لایه اول، مقاله Snapshot در استوریج HPE نحوه کار و ترکیب آن با Replication را بهتفصیل بررسی میکند. بدون Replication، تحقق SLAهای بازیابی زیر 30 دقیقه عملاً غیرممکن است.
Replication اگر درست طراحی نشود میتواند شبکه را اشباع کند یا Latency سرویسهای تولیدی را افزایش دهد. ارسال حجم بالای داده بدون QoS مناسب باعث اختلال در ترافیک Production میشود. در محیطهایی با نرخ تغییر (Change Rate) بالا، تمرین رایج این است که لینک اختصاصی یا VLAN جدا برای ترافیک Replication در نظر گرفته شود. Compression و Throttling هم نقش مهمی در کنترل مصرف پهنای باند دارند.
از نظر بار پردازشی روی استوریج، چون فقط Delta ارسال میشود، تأثیر Replication بر IOPS محدود است؛ اما اگر Snapshot و Replication همزمان فعال باشند، IO اضافی ایجاد میشود که باید در محاسبات ظرفیت لحاظ شود. یک الگوی متداول و کارآمد این است: Sync بزرگ و زمانبندیشده در ساعات کمبار شبانه و Replication لحظهای فقط برای Volumeهای حیاتی. جمعبندی این بخش ساده است: Capacity Planning و Bandwidth Sizing قبل از اجرا حیاتی است؛ طراحی DR بدون محاسبه دقیق شبکه، تقریباً همیشه به Bottleneck میخورد.
نکته دیگر، زیرساخت اتصال دو آرایه است. اگر ترافیک Replication روی FC منتقل میشود، کیفیت و کانفیگ سوئیچ SAN اچ پی نقش مستقیمی در پایداری مسیر و پهنای باند مؤثر دارد و باید هماهنگ با معماری DR طراحی شود.
Replication بیشترین کاربرد را در محیطهای مالی، درمانی، صنعتی و سرویسهای آنلاین دارد. نمونه اول: در یک کارخانه تولیدی که دیتابیس MES باید همیشه در دسترس میبود، Async Replication با بازه 60 ثانیه تنظیم شد؛ در حادثه خرابی رک، سایت دوم بلافاصله فعال شد و دادههای لحظه آخر حفظ گردید. نمونه دوم: یک تیم توسعه از Replica خواندنی (Writable Snapshot از نسخه تکرارشونده) برای محیط Dev/Test استفاده میکرد تا فشار از Production برداشته شود و نیاز به خرید استوریج جدید حذف گردد.
این مثالها نشان میدهند Replication فقط برای روز بحران نیست. کاربردهای ثانویه آن شامل Reporting مستقیم روی سایت دوم (Offload کار بارهای خواندنی)، جابهجایی بار Backup و حتی Migration بدون Downtime از یک آرایه قدیمی به آرایه جدید است. نگاه مهندسی درست این است که از Replica بیشترین ارزش عملیاتی استخراج شود، نه اینکه فقط برای فاجعه در انتظار بمانیم.
Replication همیشه بهترین گزینه نیست و گاهی هزینه آن توجیه اقتصادی ندارد. اگر کسبوکار بتواند چند ساعت Downtime را تحمل کند، Backup کافی است. همچنین لینک WAN ضعیف یا بودجه محدود ممکن است پیادهسازی Replication را غیرمنطقی کند؛ در برخی سازمانهای کوچک، هزینه خرید دو آرایه استوریج و لینک اختصاصی از خسارت احتمالی خرابی بیشتر است. معماری خوب یعنی انتخاب متناسب با SLA، نه استفاده از گرانترین فناوری موجود. اگر RPO چند ساعته قابل قبول است، ترکیب Snapshot و Backup ممکن است کافی باشد. Replication برای محیطهای Mission Critical طراحی شده است.
خیر. Replication و Backup دو لایه مکمل هستند. Replication فقط وضعیت فعلی داده را در سایت دوم نگه میدارد؛ اگر داده خراب یا Ransomware آن را رمزگذاری کند، همین خرابی تکرار میشود. Backup با تاریخچه نگهداری نسخهها، تنها راه بازگشت به گذشته است.
در حالت کلی بله، دو حالت اصلی Synchronous و Asynchronous وجود دارد؛ در ادبیات فنی حالتهای میانی مانند Semi-Synchronous هم دیده میشود. انتخاب بین آنها تابع Latency لینک و RPO مورد نیاز است.
از آنجا که Replication در استوریجهای HPE داخل خود آرایه انجام میشود و به CPU سرور وابسته نیست، بار اضافی روی هاست تحمیل نمیشود. مصرف اصلی مربوط به پهنای باند شبکه و مقدار کمی IO روی آرایه است.
Snapshot یک تصویر لحظهای از داده روی همان آرایه است و در خرابی کل دستگاه بیفایده میماند؛ Replication داده را به آرایهای در سایت دیگر منتقل میکند و مکمل Disaster Recovery است. ترکیب هر دو، الگوی استاندارد محافظت داده است.
Replication در استوریج HPE یک فناوری کلیدی برای تداوم سرویس، RPO پایین و بازیابی سریع است و در معماریهای حرفهای Disaster Recovery تقریباً ضروری محسوب میشود. انتخاب بین Sync و Async باید بر اساس Latency واقعی لینک، بودجه و SLA انجام شود و بهترین الگوی محافظت، ترکیب Snapshot + Replication + Backup در سه لایه است. قبل از اجرا، محاسبه دقیق پهنای باند و Change Rate را جدی بگیرید؛ طراحی DR بدون این محاسبات معمولاً در لحظه بحران ناکارآمد میشود. اگر نیاز به مشاوره برای انتخاب آرایه مناسب و طراحی معماری Replication دارید، بررسی گزینههای موجود در صفحه خرید استوریج HP نقطه شروع خوبی است.