افت عملکرد در سرورهای سازمانی همیشه به کمبود CPU یا رم برنمیگردد؛ در بسیاری از موارد، گلوگاه واقعی در لایه ذخیرهسازی و دقیقتر از آن، در کنترلر RAID نهفته است. Smart Array Performance Analyzer ابزار تخصصی تحلیل عملکرد کنترلر Smart Array در سرورهای HPE است که با استخراج دادههای I/O، تأخیر و وضعیت Cache نشان میدهد گلوگاه در سطح دیسک است، در کنترلر یا در پیکربندی RAID. در این مقاله با کاربرد این ابزار، شاخصهای کلیدی گزارش آن، مراحل اجرا و محدودیتهایش آشنا میشوید.
فهرست مطالب
Smart Array Performance Analyzer یک قابلیت تحلیلی تخصصی برای کنترلرهای Smart Array در سرورهای HPE ProLiant است که دادههای عملکردی کنترلر را استخراج میکند و الگوهای خواندن و نوشتن، تأخیر (Latency)، صفهای پردازش (Queue) و وضعیت Cache را بهصورت قابل تفسیر در اختیار تیم زیرساخت قرار میدهد. خروجی این تحلیل نشان میدهد رفتار I/O در تعامل کنترلر با دیسکهای فیزیکی و Logical Driveها چگونه شکل گرفته است.
تفاوت اصلی این ابزار با پلتفرمهای مانیتورینگ عمومی در عمق تحلیل است: ابزارهای عمومی تصویر کلی از CPU، رم و شبکه ارائه میدهند، اما Smart Array Performance Analyzer مستقیماً روی لایه کنترلر RAID تمرکز میکند. در عمل، این تحلیل در کنار ابزارهای مدیریتی HPE مانند Smart Storage Administrator (SSA) و رابط خط فرمان ssacli انجام میشود و مرز مشکل را روشن میکند: آیا گلوگاه در دیسک است، در کنترلر، در Cache یا در خود پیکربندی RAID.
کنترلرهای Smart Array در سرورهای HPE ProLiant نسل Gen9 تا Gen11 میان پردازنده و دیسکهای SAS/SATA (و در برخی پیکربندیها NVMe) قرار میگیرند و مدیریت RAID Levelها، حافظه Cache و Write Policy بر عهده آنهاست. مسیر هر درخواست I/O از سیستمعامل آغاز میشود، به کنترلر میرسد، در صف پردازش مینشیند، در صورت امکان از Cache سرویس میگیرد و در نهایت روی آرایه دیسکی نوشته یا از آن خوانده میشود. هر حلقه از این زنجیره میتواند گلوگاه ایجاد کند و علائم هر گلوگاه در شاخصهای عملکردی متفاوت دیده میشود.
به همین دلیل، تفسیر درست خروجی Analyzer بدون شناخت این معماری ممکن نیست. وقتی بدانید Cache چه نقشی در جذب Writeهای تصادفی دارد، افت ناگهانی Write Latency را بهجای کمبود دیسک، به تغییر Write Policy نسبت میدهید؛ و وقتی بدانید صفها کجا شکل میگیرند، Queue Depth بالا را بهدرستی به تمرکز بار روی یک Logical Drive ربط میدهید. این شناخت، داده خام را به تصمیم معماری تبدیل میکند.
Write Back و Write Through دو سیاست پایه نوشتن در کنترلرهای Smart Array هستند. در حالت Write Back، داده ابتدا در Cache ثبت و سپس روی دیسک نوشته میشود؛ این حالت عملکرد Write را بهطور محسوسی بالا میبرد اما به محافظت Cache در برابر قطع برق (Battery یا Flash Backup) وابسته است. اگر ماژول محافظ دچار خطا شود، کنترلر برای حفظ سلامت داده خودکار به Write Through برمیگردد و تأخیر نوشتن بهشدت افزایش مییابد؛ الگویی که در تحلیل عملکرد بهسادگی قابل تشخیص است. برای درک عمیقتر مکانیزمهای کش، مقاله
قابلیت Smart Cache روی RAID کنترلرهای HPE را بخوانید.
پیش از بهکارگیری این ابزار عیبیابی سرور HP، چند پیشنیاز فنی باید فراهم باشد تا دادههای استخراجشده قابل اتکا باشند. نبود هر یک از این موارد میتواند تحلیل را به نتایج گمراهکننده برساند؛ برای مثال درایور قدیمی یا فریمور ناهماهنگ، خودش منبع افت عملکرد است و تفسیر شاخصها را پیچیده میکند.
بهعلاوه، دسترسی به شمارندههای سیستمعامل مانند PerfMon در ویندوز یا ابزار iostat در لینوکس کمک میکند رفتار Latency و IOPS را از دید سیستمعامل هم ببینید و با وضعیت گزارششده در سطح کنترلر تطبیق دهید. این تطبیق دو لایه، از برداشتهای یکسویه جلوگیری میکند و در محیطهای مجازیسازیشده میتواند با گزارشهای Hypervisor نیز تکمیل شود.
نقطه شروع درست، شناسایی دقیق علائم است: Latency غیرعادی روی Logical Driveها، IOPS پایینتر از انتظار نسبت به سختافزار، رفتار نامتوازن میان Logical Driveهای مختلف، یا شکایت کاربران از کندی در حالی که مصرف CPU و رم نرمال است. در چنین شرایطی ابزارهای عمومی مانند iLO یا vCenter تنها بخشی از تصویر را نشان میدهند و نگاه تخصصی به لایه کنترلر ضروری میشود.
سه محرک رایج در این وضعیت بیشتر از همه دیده میشوند. نخست، ناهمخوانی RAID Level با الگوی کاری؛ مثلاً استفاده از RAID5 برای دیتابیس OLTP با Write سنگین. دوم، سقوط ناخواسته Write Back به Write Through به دلیل خطای Battery یا تنظیمات نادرست. سوم، فریمور قدیمی کنترلر که با نسخههای جدید ESXi یا Windows Server سازگاری کامل ندارد. خروجی Analyzer در این موارد مشخص میکند باید RAID را تغییر دهید، Cache را ارتقا دهید، فریمور را بهروز کنید یا حتی به HBA Mode بروید؛ همین مرزبندی از خریدهای غیرضروری جلوگیری میکند.
در محیطهایی با بار کاری سنگین و پیوسته — مجازیسازی گسترده، دیتابیسهای سازمانی یا کاربردهای HPC مانند سرورهای HPE Apollo در محیطهای HPC — رفتار I/O کنترلر بهطور مستقیم بر عملکرد کل سرویس اثر میگذارد و تحلیل دورهای کنترلر باید بخشی از رویههای پایش باشد، نه اقدامی صرفاً پس از وقوع بحران.
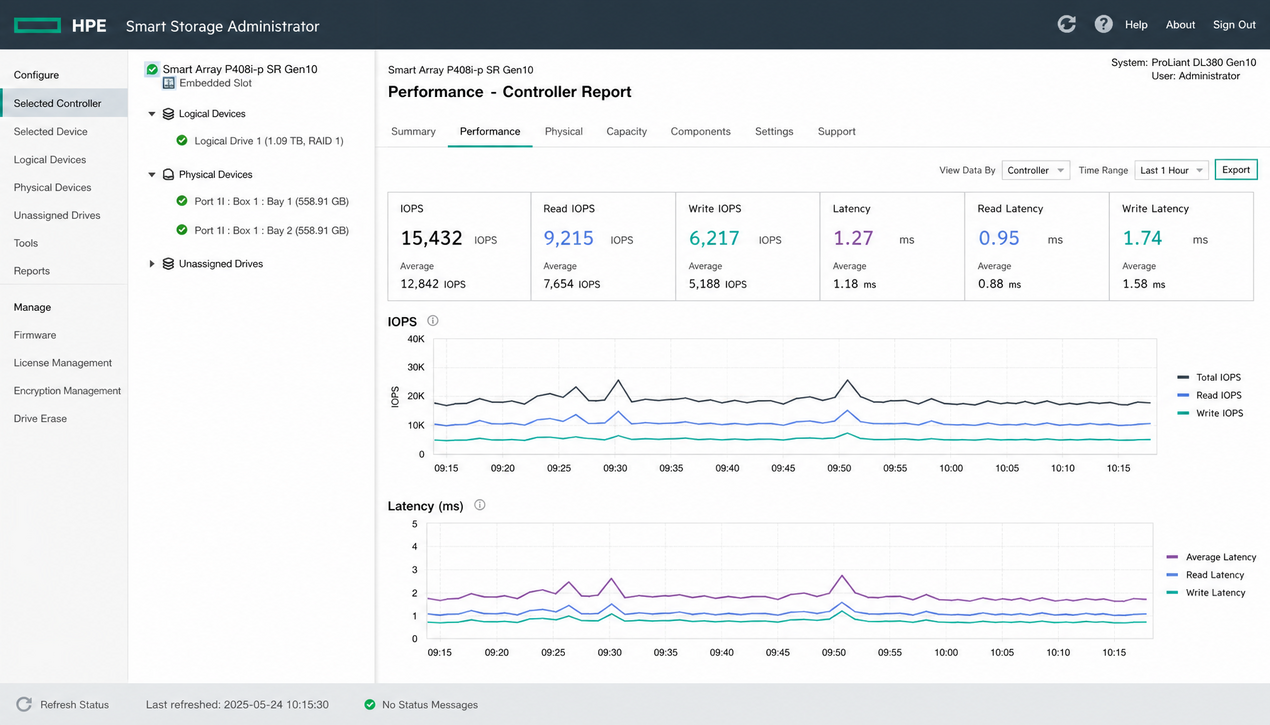
هسته هر گزارش عملکرد کنترلر، سه شاخص است: Latency، IOPS و Queue Depth. تفسیر صحیح و همزمان این سه، مرز بین یک تحلیل سطحی و یک تصمیم معماری درست را مشخص میکند. نکته مهم این است که Latency بالا لزوماً به معنای کمبود دیسک نیست؛ ممکن است ناشی از اشباع Cache، توزیع نامتعادل بار یا رویدادهای موقتی مانند Rebuild آرایه باشد. این ابزار داده خام نمیدهد، بلکه امکان تحلیل روند و همبستگی شاخصها را فراهم میکند.
Latency نشان میدهد هر درخواست خواندن یا نوشتن چه مدت تا تکمیل طول کشیده است. تفکیک Read Latency از Write Latency اهمیت حیاتی دارد، زیرا مشکلات Cache و Write Policy عمدتاً خود را در Write Latency نشان میدهند. مقدار قابلقبول به نوع دیسک (HDD، SAS 10K یا SSD)، الگوی کاری و توافق سطح سرویس بستگی دارد؛ ملاک درست، مقایسه با Baseline سیستم خودتان و پایش روند تغییرات است، نه یک عدد مطلق.
IOPS تعداد عملیات ورودی/خروجی در ثانیه است و بدون توجه به ترکیب Read/Write و نسبت Random/Sequential، تفسیرش گمراهکننده میشود. IOPS بالا در کنار Latency بالا نشانه اشباع کنترلر یا Cache است، نه عملکرد خوب؛ در مقابل، IOPS پایین با Latency بالا معمولاً به ضعف دیسک فیزیکی، خرابی پنهان یا درگیری آرایه در Rebuild اشاره دارد. مقایسه IOPS بین Logical Driveها نیز توزیع بار را آشکار میکند.
Queue Depth طول صف درخواستهای در انتظار در کنترلر و دیسکهاست. صف بلندِ متمرکز روی یک Logical Drive خاص معمولاً یعنی Workload روی همان حجم منطقی متمرکز شده و چند ماشین مجازی یا سرویس پرمصرف بر سر آن رقابت میکنند؛ صف بلند سراسری روی همه Logical Driveها به اشباع کل کنترلر یا محدودیت Cache اشاره میکند. این شاخص برای تصمیمهای توزیع بار و انتخاب Stripe Size ارزش زیادی دارد.
در عمل، شاخصها را نباید جدا از هم دید؛ ارزش تحلیلی از همبستگی آنها به دست میآید. جدول زیر رایجترین ترکیبهای دیدهشده در گزارش Latency و IOPS کنترلر Smart Array و مسیر پیشنهادی هر یک را جمعبندی میکند. توجه کنید که چند الگو میتوانند همزمان در یک سرور حضور داشته باشند؛ در این حالت ابتدا مسئله سلامت دیسک را رفع کنید تا تصویر بقیه شاخصها شفاف شود.
| الگوی مشاهدهشده | تفسیر احتمالی | اقدام پیشنهادی |
|---|---|---|
| Latency بالا + IOPS پایین | ضعف یا خرابی پنهان دیسک فیزیکی، Rebuild در جریان | بررسی سلامت Physical Driveها و وضعیت آرایه در HPE SSA |
| IOPS بالا + Latency بالا | اشباع کنترلر یا Cache | بازبینی Cache Policy و Write Policy، ارتقای Cache یا توزیع بار |
| Queue Depth بالا فقط روی یک Logical Drive | تمرکز Workload روی یک حجم منطقی | توزیع مجدد ماشینهای مجازی یا دادهها، بازبینی Stripe Size |
| Latency بالا فقط در بازه زمانی مشخص | تداخل Jobهای زمانبندیشده مانند Backup شبانه | جابهجایی زمانبندی Jobها و مقایسه مجدد |
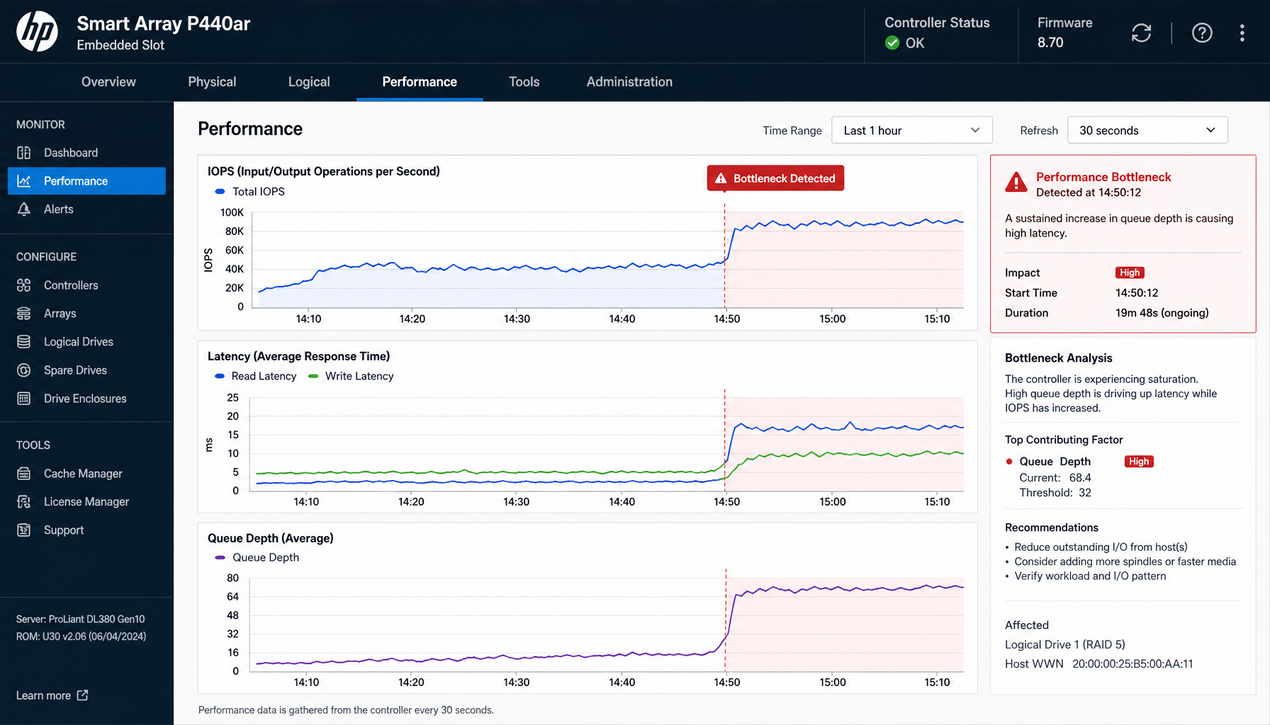
برای اجرای تحلیل باید از طریق سیستمعامل یا محیط مدیریتی سرور به کنترلر دسترسی داشته باشید و گزارش عملکرد را در بازه زمانی مشخصی استخراج کنید. توصیه عملی در این مرحله روشن است: تحلیل را در ساعات پیک بار انجام دهید، نه در زمان Idle؛ دادههای کمبار تقریباً هیچ گلوگاهی را نشان نمیدهند و میتوانند تصویری خودراضیکننده و نادرست ایجاد کنند.
در سرورهای HPE، رابط خط فرمان ssacli امکان بازبینی پیکربندی و وضعیت کنترلر را بدون ایجاد تغییر فراهم میکند. نام این ابزار بسته به نسل سرور و سیستمعامل میتواند ssacli، hpssacli یا در نسلهای قدیمیتر hpacucli باشد و در ویندوز فایل اجرایی آن در مسیر نصب HPE SSA قرار میگیرد. دستورهای زیر همگی از نوع نمایش وضعیت (show) هستند و تغییری در پیکربندی ایجاد نمیکنند؛ پیش از اجرا، تناسب دستورها با نسخه ابزار نصبشده روی سرور خود را در مستندات HPE بررسی کنید:
برای دیدن Latency و IOPS از دید سیستمعامل، شمارندههای PerfMon در ویندوز (مانند Avg. Disk sec/Read و Disk Transfers/sec) یا خروجی ابزار iostat در لینوکس (از بسته sysstat) مکمل مناسبی برای دادههای سطح کنترلر هستند. اگر تأخیر در دو لایه همخوانی داشت، مشکل واقعاً در مسیر ذخیرهسازی است؛ اگر فقط در یک لایه دیده شد، باید عواملی مانند صف در سطح سیستمعامل یا فایلسیستم نیز بررسی شود.
خروجی Analyzer را باید در کنار Workload واقعی تفسیر کرد. اگر پیک Latency دقیقاً همزمان با Backup شبانه رخ میدهد، احتمالاً مشکل تداخل Jobهاست نه ساختار RAID؛ اگر Write Latency فقط در ساعات اوج دیتابیس بالا میرود، بهجای تغییر RAID Level ابتدا Cache Policy و سلامت ماژول محافظ Cache را بررسی کنید. مقایسه دو بازه پیک و غیرپیک، این همبستگیها را آشکار میکند و از تصمیمهای تکبازه و شتابزده جلوگیری میکند. تحلیل بدون درک Context عملیاتی، به نتیجه اشتباه میرسد.
برای درک بهتر کاربرد ابزار، دو الگوی شایع را مرور میکنیم؛ الگوهایی که در تحلیل رفتار کنترلرهای Smart Array مکررند و مسیر عیبیابی مشخصی دارند. این موارد را بهعنوان چارچوب تصمیمگیری ببینید، نه گزارش یک استقرار خاص. نکته اصلی هر دو یکسان است: دادههای عملکردی کنترلر پیش از هر اقدام سختافزاری بررسی میشوند و همین ترتیب، از هزینههای بینتیجه جلوگیری میکند.
شرایط اولیه این الگو آشناست: مصرف CPU و رم نرمال است، اما کاربران دیتابیس با Timeout در Queryها مواجه میشوند. تحلیل کنترلر نشان میدهد Write Latency در ساعات اوج جهش میکند و Cache Hit Ratio بهشدت افت میکند. بررسی ماژول Cache روشن میسازد که به دلیل خطای Battery، کنترلر برای حفظ سلامت داده، Write Back را غیرفعال کرده است. راهحل درست، تعویض ماژول محافظ و فعالسازی مجدد Write Back است؛ اقدامی که مشکل را از ریشه رفع میکند و نیاز به خرید SSD اضافه را منتفی میسازد.
در الگوی دوم، دیسکهای SAS 10K با SSD جایگزین شدهاند اما بهبود محسوسی در عملکرد دیده نمیشود. تحلیل کنترلر سه مورد را آشکار میکند: آرایه همچنان روی RAID6 با Stripe Size نامتناسب قرار دارد، Queue Depth کنترلر به سقف رسیده و Firmware بهروز نیست. پس از بهروزرسانی Firmware، بازطراحی آرایه به RAID10 و تناسبکردن Stripe Size با الگوی I/O، ظرفیت واقعی SSDها آزاد میشود. درس این الگو روشن است: ارتقای سختافزار بدون تحلیل رفتار کنترلر و اصلاح پیکربندی، لزوماً به بهبود عملکرد نمیانجامد. اگر در پایان تحلیل تصمیم به ارتقای دیسک گرفتید، انتخاب
هارد سرور اچ پی متناسب با الگوی کاری و کنترلر موجود، شرط رسیدن به نتیجه مورد انتظار است.
این ابزار قدرتمند است اما همه مشکلات Storage را حل نمیکند و شناخت مرزش برای تصمیمگیری معماری ضروری است. تمرکز Analyzer بر لایه کنترلر داخلی است؛ بنابراین مشکلات شبکه SAN، تنظیمات Hypervisor و گلوگاههای سطح Application را مستقیماً تحلیل نمیکند. اگر معماری شما به Storage خارجی SAN یا NAS متکی است، تحلیل صرفِ کنترلر داخلی کافی نیست و دادههای آرایه خارجی نیز باید جداگانه بررسی شود.
همچنین در سناریوهای HBA Mode یا NVMe Direct که کنترلر نقش فعالی در مسیر I/O ندارد، رفتار سیستم متفاوت است و ابزارهای سنجش در سطح سیستمعامل و دیسک جایگزین میشوند. خطر واقعی، تفسیر نادرست است: اگر ریشه کندی در Queryهای بد نوشتهشده دیتابیس باشد، تغییر RAID یا خرید دیسک نهتنها کمکی نمیکند، بلکه هزینه و پیچیدگی اضافه میآفریند. بلوغ یک تیم زیرساخت در این است که بداند چه زمانی تحلیل را به لایه سیستمعامل، شبکه یا اپلیکیشن بسط دهد.
خیر. iLO برای مدیریت Out-of-Band، پایش سلامت سختافزار و دسترسی از راه دور طراحی شده، در حالی که این تحلیل بر رفتار I/O کنترلر و شاخصهای عملکردی تمرکز دارد. این دو مکمل یکدیگرند: iLO وضعیت کلی سختافزار را نشان میدهد و تحلیل عملکردی توضیح میدهد همان سختافزار چرا کند پاسخ میدهد.
میزان دسترسی به قابلیتهای تحلیل عملکرد به نسل کنترلر، نسخه Firmware و نسخه ابزارهای مدیریتی نصبشده بستگی دارد. کنترلرهای رایج نسل Gen9 تا Gen11 مانند P440ar و P816i با نسخههای بهروز HPE SSA و ssacli پوشش داده میشوند؛ برای مدلهای خاص، فهرست سازگاری را در مستندات رسمی HPE بررسی کنید.
پلتفرمهای عمومی تصویر وسیع اما سطحی از کل سیستم میدهند؛ این تحلیل عمیق اما محدود به لایه کنترلر RAID است و جزئیاتی مانند Cache Policy، وضعیت Battery، Queue Depth و توزیع بار میان Logical Driveها را نشان میدهد که در ابزارهای عمومی دیده نمیشود. بهترین نتیجه از ترکیب هر دو دید به دست میآید.
Smart Array Performance Analyzer زمانی ارزش حیاتی دارد که میان ارتقای سختافزار، تغییر RAID یا بازطراحی Workload مردد ماندهاید و به داده دقیق از رفتار کنترلر نیاز دارید. این ابزار دید شفافی از لایهای میدهد که در تحلیلهای سطحی اغلب نادیده گرفته میشود؛ همان لایهای که تعیین میکند سرمایهگذاری روی دیسک و سرور نتیجه بدهد یا هدر برود.
پیش از خرید دیسک جدید یا مهاجرت به سرور قویتر، تحلیل عملکرد کنترلر را در دستور کار قرار دهید. در بسیاری از موارد، تنظیم صحیح Cache Policy، اصلاح RAID Level و Stripe Size یا توزیع مجدد بار، تأثیر بیشتری از افزودن سختافزار دارد؛ و اگر تحلیل نشان داد ارتقای دیسک اجتنابناپذیر است، انتخاب از میان گزینههای
هارد استوریج HP باید بر اساس دادههای همین تحلیل انجام شود. تصمیم درست، تصمیم مبتنی بر داده است؛ رویکردی که وینو سرور نیز در مشاوره زیرساخت و بررسی عملکرد سرورهای HPE به آن پایبند است.