کند شدن سرور معمولا نتیجه یک عامل واحد نیست؛ ترکیبی از کمبود منابع، پیکربندی نادرست سیستمعامل، تنظیمات اشتباه وبسرور و کوئریهای سنگین دیتابیس باعث افت سرعت میشود. راهحل درست، ابتدا پیدا کردن گلوگاه با ابزارهایی مثل htop و iostat است و بعد از اصلاح تنظیمات؛ خرید سختافزار جدید مانند CPU سرور یا رم سرور HP فقط وقتی معنادار است که تحلیل نشان دهد منبع واقعا کم است. در این مقاله 7 دلیل اصلی کندی و راهکارهای افزایش سرعت سرور را بررسی میکنیم.
بدیهیترین دلیل کند شدن سرور، کمبود واقعی منابع است، اما نه آنطور که معمولا تصور میشود. فرض اول بسیاری از تیمها این است که «منابع کم است و باید سرور قویتری بخریم»، در حالی که در بسیاری از موارد مشکل از عدم تناسب منابع با الگوی مصرف است، نه از مقدار خام منابع.
مثال مشخص: سروری با 16 گیگابایت RAM و 8 هسته CPU زیر بار یک وبسایت نسبتا ساده دچار تاخیر میشود، در حالی که سرور دیگری با نصف این منابع عملکرد بهتری دارد. تفاوت در جای دیگری است: در پروژهای فروشگاهی، مصرف RAM پایین بود اما IO دیسک به سقف رسیده بود، چون تمام سشنها روی دیسک SATA ذخیره میشدند. ارتقای RAM هیچ تاثیری نداشت، اما مهاجرت به NVMe مشکل را حل کرد.
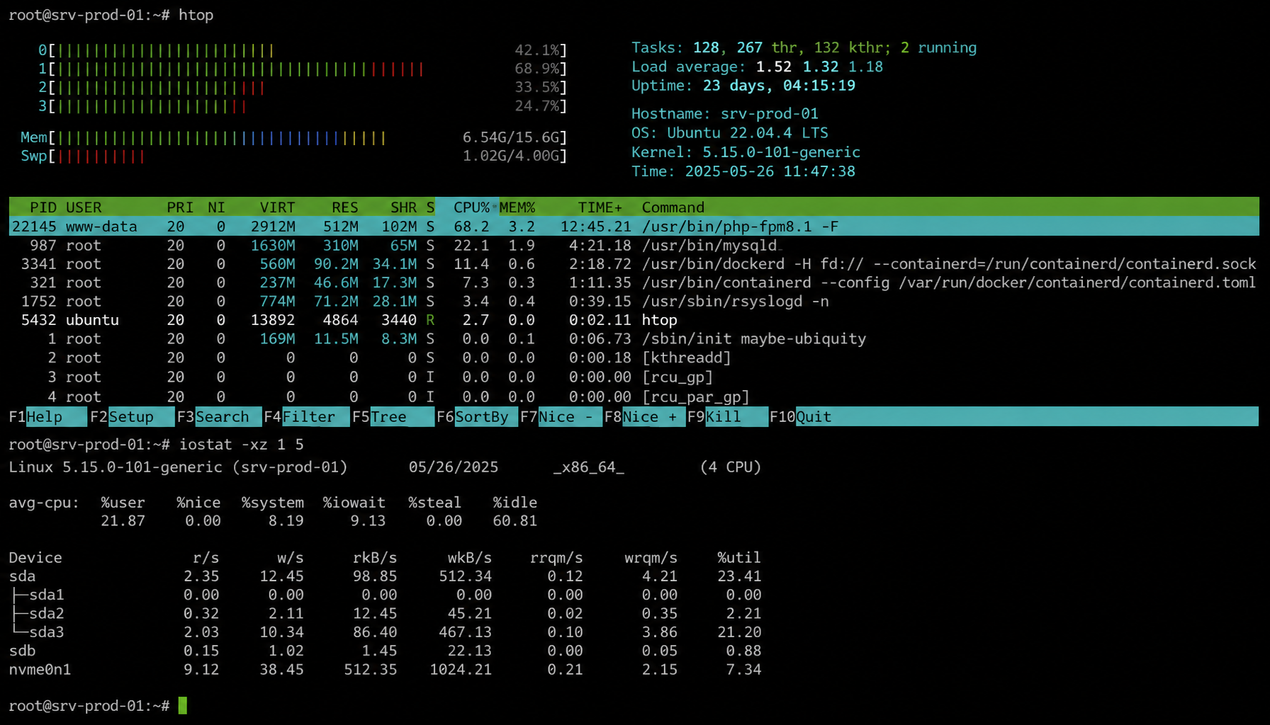
از نظر فنی باید مشخص کنید کدام منبع گلوگاه است: CPU-bound، memory-bound یا IO-bound. ابزارهایی مثل htop، iostat و vmstat تصویر دقیقی میدهند، اما تفسیر خروجی مهمتر از دیدن عددهاست. CPU بالا همیشه بد نیست؛ اما CPU بالا همراه با load average غیرعادی (بهطور مثال عددی چند برابر تعداد هستهها) نشانه صف پردازش است. خرید سرور قویتر بدون این تحلیل، اغلب فقط هزینه را بالا میبرد.
بخش بزرگی از کندی سرورها نه به سختافزار مربوط است و نه به اپلیکیشن، بلکه به تنظیمات پیشفرض سیستمعامل برمیگردد. تنظیمات پیشفرض اکثر توزیعهای لینوکس برای محیطهای عمومی طراحی شدهاند، نه برای سروری که زیر بار production قرار دارد.
نمونه واقعی: در یک سرویس محتوایی پرترافیک، منابع کاملا آزاد بود اما TTFB بالا میرفت. بررسی نشان داد پارامترهای TCP مانند net.core.somaxconn و net.ipv4.tcp_tw_reuse روی مقادیر پیشفرض بودند. پس از تنظیم صحیح این پارامترها و افزایش backlog، تاخیر پاسخگویی به شکل محسوسی کاهش پیدا کرد. برای مطالعه دقیق معنای هر پارامتر، مستندات رسمی کرنل لینوکس درباره پارامترهای sysctl در مسیر /proc/sys مرجع معتبری است.
چند نکته کاربردی در این لایه:
بهینهسازی سیستمعامل یکی از کمهزینهترین و پربازدهترین اقدامات برای افزایش سرعت سرور است، چون نه خرید سختافزار میطلبد و نه تغییر در کد اپلیکیشن.
وبسرور و لایههای میانی مثل PHP-FPM یا محیط اجرای Node.js نقش تعیینکنندهای در سرعت نهایی دارند. کندی در این لایه اغلب به شکل صف شدن درخواستها بروز میکند، در حالی که CPU و RAM کاملا آزاد به نظر میرسند.
در یک نمونه واقعی، وبسایتی با Nginx و PHP-FPM روی سرور اختصاصی کند بود و دیتابیس سالم. بررسی نشان داد تعداد workerهای PHP-FPM کمتر از concurrency واقعی کاربران تنظیم شده بود؛ نتیجه، صف شدن درخواستها و افزایش response time بود. اما توجه کنید که افزایش بیهدف workerها هم خطرناک است، چون هر worker حافظه مصرف میکند و تعداد بیش از حد باعث exhaustion رم و رفتار بدتر از قبل میشود. عدد درست از حاصلضرب حافظه متوسط هر فرایند در تعداد workerها و مقایسه آن با RAM موجود به دست میآید.
همین منطق در Nginx هم صدق میکند. تنظیم اشتباه worker_connections یا استفاده نادرست از keepalive میتواند throughput را بهطور محسوسی کاهش دهد. اگر ترافیک شما شامل پاسخهای کوچک و پرتکرار است، فعال بودن keepalive و تنظیم درست timeout آن اثر مستقیم روی تعداد connection های برقرار در ثانیه دارد.
بسیاری از موارد کندی با بازبینی ساده config و تطبیق آن با الگوی ترافیک حل میشوند؛ نه تعویض وبسرور لازم است و نه مهاجرت عجولانه به تکنولوژی جدید. تصمیم درست گاهی یعنی «هیچ چیز نخریم، فقط درست تنظیم کنیم».
اگر از لایههای میانی مثل F5 برای مدیریت ترافیک استفاده میکنید، مرور راهنمای بهترین تنظیمات SSL Offloading روی F5 میتواند بخشی از بار رمزنگاری را از وبسرور شما بردارد.
در بسیاری از پروژههایی که با شکایت از کندی سرور بررسی میشوند، عامل اصلی دیتابیس است، حتی وقتی تیم مطمئن است همه چیز سالم است. نشانههای کلاسیک این وضعیت: کندی فقط در برخی صفحات، بالا رفتن latency در ساعات پیک، و CPU بالای دیتابیس در حالی که وبسرور آرام است.
قاعده عملی این است: بررسی دیتابیس و slow query log همیشه باید قبل از تصمیم به خرید سختافزار انجام شود، چون در غیر این صورت هزینه میکنید و مشکل باقی میماند. افزایش رم ممکن است فقط زمان رسیدن به گلوگاه را چند ماه عقب بیندازد.
لایه ذخیرهسازی معمولا آخرین لایهای است که در عیبیابی بررسی میشود، در حالی که تاثیر مستقیمی روی latency دارد. انتخاب نوع دیسک باید با الگوی کاری متناسب باشد؛ دیسک NVMe برای کاربردهای حساس به تاخیر مثل دیتابیسهای تراکنشی، و HDD برای آرشیو و ذخیرهسازی ترتیبی. اگر قصد ارتقا یا جایگزینی دارید، مقاله بهترین هارد سرور 2025 برای NVMe، SAS و HDD مقایسه کاملی بین این فناوریها ارائه میدهد.
دو نکته که در عمل فراموش میشود:
بسیاری از موارد کندی اصلا داخل سرور نیستند، بلکه در مسیر ارتباطی رخ میدهند. تمرکز صرف روی منابع سرور در این حالت دیدی ناقص میدهد و منجر به هزینههای بینتیجه میشود.
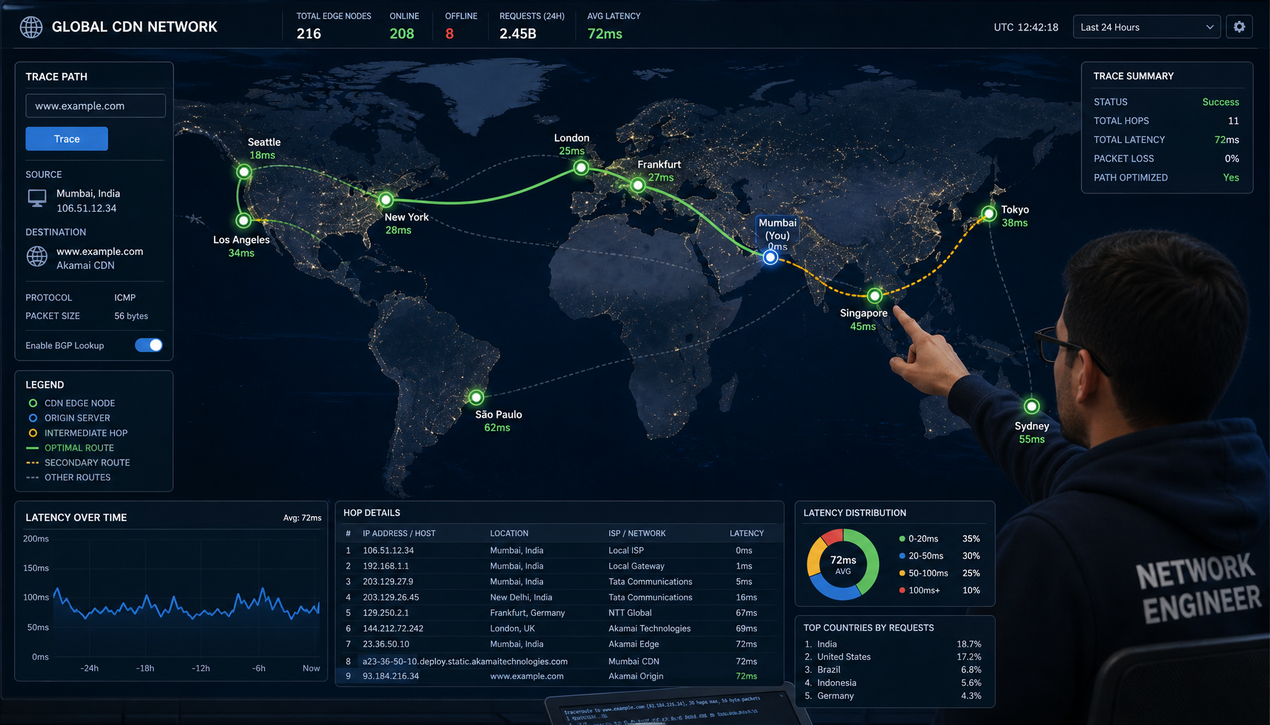
در یک نمونه واقعی، کاربران منطقهای دور از سرور از کندی شکایت داشتند اما سرور کاملا سالم بود. بررسی latency شبکه نشان داد مسیر routing نامناسب و عدم استفاده از CDN باعث تاخیر شده است. انتقال بخشی از ترافیک به edge و اصلاح تنظیمات، مشکل را حل کرد.
در این لایه این موارد را بررسی کنید:
ابزارهای ساده مثل ping و traceroute فقط تصویر اولیه میدهند؛ برای تحلیل جدی، اندازهگیری latency و packet loss به شکل مستمر روی مسیر واقعی کاربران لازم است.
یک دلیل که همیشه باید در ذهن داشته باشید: کندی میتواند علامت یک رخداد امنیتی باشد، نه ضعف فنی. فرایندهای مخرب مثل crypto mining معمولا به شکل مصرف CPU بالای مداوم دیده میشوند که با الگوی ترافیک شما همخوانی ندارد. چند نشانه هشدار:
در چنین مواردی ابتدا باید ریشهیابی امنیتی انجام شود؛ هیچ مقدار ارتقای سختافزاری کندی ناشی از فعالیت مخرب را برطرف نمیکند. برای سرورهای HP، اجرای چکلیستهای افزایش امنیت سرور HP در برابر حملات سایبری گام اولیه مناسبی است.
بهجای حدس زدن، این ترتیب را دنبال کنید تا گلوگاه واقعی پیدا شود:
مهمترین اصل این روند، ثبت وضعیت پایه (baseline) است. بدون دانستن وضعیت طبیعی سرور در ساعات کمبار، نمیتوانید بگویید وضعیت فعلی «غیرعادی» است؛ مقایسه با داده تاریخی، عیبیابی را از حدس به سنجش تبدیل میکند.
خیر. در بسیاری از موارد، مشکل از پیکربندی سیستمعامل، تنظیمات وبسرور یا کوئریهای دیتابیس است. خرید سختافزار بدون تحلیل، هم هزینه اضافه میکند و هم مشکل را حل نمیکند.
اجرای همزمان htop، iostat و بررسی مصرف RAM و swap. اگر CPU آزاد است اما iowait بالاست مشکل دیسک است؛ اگر رم آزاد است اما صف پردازش طولانی است، احتمالا مشکل در تعداد workerهای وبسرور یا کوئریهای دیتابیس است.
وقتی پس از رفع مشکلات نرمافزاری و پیکربندی، منبع اصلی همچنان بهطور پایدار نزدیک سقف باشد؛ مثلا رم بهطور مرتب بالای 90 درصد یا دیسک با iowait بالا در ساعات پیک. در آن نقطه، ارتقای دیسک به NVMe، افزودن رم یا جایگزینی CPU واقعا اثر میگذارد.
برای محتوای استاتیک و کاربران پراکنده جغرافیایی، تقریبا همیشه بله. برای اپلیکیشنهای کاملا داینامیک با کاربران محلی، تاثیر CDN محدودتر است و تمرکز باید روی دیتابیس و لایه میانی باشد.
کند شدن سرور همیشه علامت کمبود منابع نیست؛ اغلب نشانه تصمیمهای نادرست در معماری، پیکربندی یا تحلیل است. دلایل اصلی را بشناسید: عدم تناسب منابع با الگوی مصرف، تنظیمات پیشفرض سیستمعامل، تعداد اشتباه workerها در وبسرور، کوئریهای بدون ایندکس، گلوگاه IO دیسک، مشکلات شبکه و در نهایت رخدادهای امنیتی. کارشناس واقعی کسی است که گلوگاه را با داده تشخیص دهد، نه اینکه با افزایش منابع صورت مسئله را پاک کند. اگر بعد از این تحلیل مشخص شد که منبعی واقعا به سقف رسیده، انتخاب سختافزار متناسب مانند CPU یا رم باکیفیت، نتیجه بهینهسازی را تثبیت میکند؛ اما همیشه اول فکر، بعد هزینه.