تداوم سرویس در شبکههای سازمانی امروزی یک انتخاب نیست؛ یک ضرورت است. فایروال بهعنوان دروازهبان امنیتی شبکه، نقشی محوری ایفا میکند و در عین حال، اگر تنها یک دستگاه باشد، به یک نقطه شکست منفرد (Single Point of Failure) تبدیل میشود. تنظیمات High Availability در فایروال سوفوس (Sophos) با ایجاد خوشهای از دو دستگاه، این نقطه ضعف را حذف کرده و تداوم خدمات را حتی در زمان خرابی یکی از گرهها تضمین میکند. در این راهنما، مفاهیم پایه، پیشنیازها، مراحل گامبهگام پیکربندی و روشهای تست و عیبیابی این معماری را بهصورت تخصصی بررسی میکنیم.
هر دقیقه قطعی فایروال میتواند به زیان مالی مستقیم، آسیب به اعتبار برند و نارضایتی مشتریان منجر شود. در استقرارهای سازمانی، حذف نقطه شکست منفرد گامی اساسی در طراحی شبکهای تابآور است. خوشه High Availability در سوفوس با ترکیب دو دستگاه یکسان، ساختاری افزونه میسازد که در صورت خرابی یک گره، دیگری بهصورت خودکار وظایف آن را بر عهده میگیرد.
قلب تپنده این معماری، مکانیزم Stateful Synchronization
است؛ یعنی گره ثانویه نه تنها پیکربندی، بلکه وضعیت لحظهای تمام اتصالات شبکه (شامل آدرسها و پورتهای مبدأ و مقصد، شماره توالی TCP و تایمرهای انقضا) را بهصورت بلادرنگ از گره اصلی دریافت میکند. نتیجه این همگامسازی آن است که در لحظه Failover، کاربری که در حال دانلود فایل، مکالمه VoIP یا کار با یک اپلیکیشن تحت وب است، عملاً هیچ اختلالی را حس نمیکند.
سوفوس بهشدت توصیه میکند که این همگامسازی از طریق یک Interface اختصاصی و ایزوله از لینکهای داده انجام شود. تأخیر بالا یا از دست رفتن بسته روی این کانال میتواند به ناسازگاری وضعیت (State Mismatch) و مشکلات عملکردی پس از Failover منجر شود. اگر قصد دارید دستگاه مناسب این استقرار را انتخاب کنید، صفحه
خرید فایروال سوفوس گزینههای متناسب با سایز سازمان شما را پوشش میدهد.
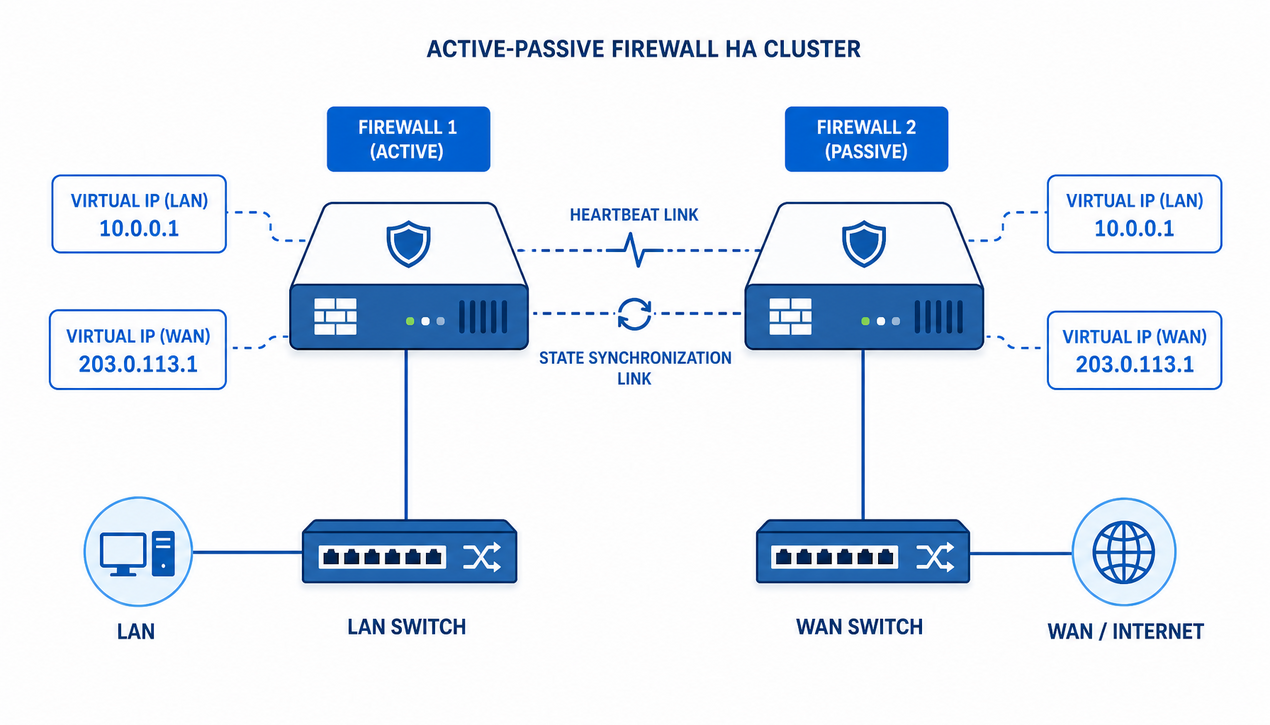
در این رایجترین و پایدارترین مدل، یک دستگاه بهعنوان گره فعال (Primary) تمام ترافیک را پردازش میکند و دستگاه دوم در حالت آمادهبهکار (Passive) بهطور مداوم پیکربندی و وضعیت جلسات را دریافت میکند. مزایای این مدل شامل سادگی طراحی، عیبیابی آسانتر و تضمین عدم تداخل در اعمال سیاستها است. کاربرد ایدهآل آن، محیطهایی است که هدف اصلیشان حذف نقطه شکست منفرد بدون نیاز به افزایش ظرفیت پردازشی است.
در این مدل پیشرفتهتر، هر دو گره همزمان ترافیک را پردازش میکنند و توزیع بار معمولاً با مکانیزمهای مسیریابی مانند ECMP یا یک Load Balancer خارجی انجام میشود. مزیت اصلی، بهرهوری بیشتر از سرمایهگذاری سختافزاری و امکان نگهداری یک گره بدون قطع کامل سرویس است؛ اما در مقابل، پیچیدگی پیکربندی و عیبیابی بهمراتب بیشتر است و همگامسازی وضعیت بین گرههای فعال حیاتیتر میشود، زیرا یک جلسه ممکن است بین دو گره جابهجا شود.
پیش از شروع پیکربندی، رعایت دقیق این پیشنیازها شرط تشکیل یک خوشه پایدار است:
در این بخش، پیکربندی Failover در فایروال سوفوس را مرحله به مرحله پیش میبریم. توجه کنید که پیش از شروع، هر دو دستگاه باید بهصورت مستقل با آخرین نسخه پایدار سیستمعامل راهاندازی و آدرس IP مدیریت روی آنها تنظیم شده باشد.
ابتدا یک طرح نامگذاری واضح برای پورتها تهیه کنید (مثلاً Port1-WAN، Port2-LAN، Port3-HA-Sync، Port4-Heartbeat) و آن را مستند کنید. سپس دستگاه Primary را بهطور کامل پیکربندی کنید: قواعد فایروال، NAT، سیاستها و Zoneها. در پایان از پیکربندی یک Backup بگیرید.
دستگاه دوم را به تنظیمات کارخانه بازگردانید (Factory Reset) و فایل پشتیبان دستگاه اول را روی آن بازیابی کنید. این کار تضمین میکند هر دو دستگاه از نظر منطقی یکسان باشند. هشدار مهم: پس از بازیابی، آدرس IP مدیریت هر دو دستگاه یکی است؛ بنابراین بلافاصله و پیش از اتصال همزمان هر دو به شبکه عملیاتی، آدرسدهی را اصلاح کنید.
پورتهای فیزیکی را مطابق طرح از پیش تعیینشده در هر دو دستگاه تعریف کنید. نوع اتصال (Static/DHCP/PPPoE) و VLANها باید کاملاً یکسان باشند. سپس Interfaceهای مربوط به LAN، DMZ و WAN را در Zoneهای مشابه در هر دو گره قرار دهید؛ سازگاری Zone برای عملکرد صحیح قواعد فایروال حیاتی است.
برای هر Interface داده (مانند LAN و WAN)، باید سه آدرس تعریف شود:
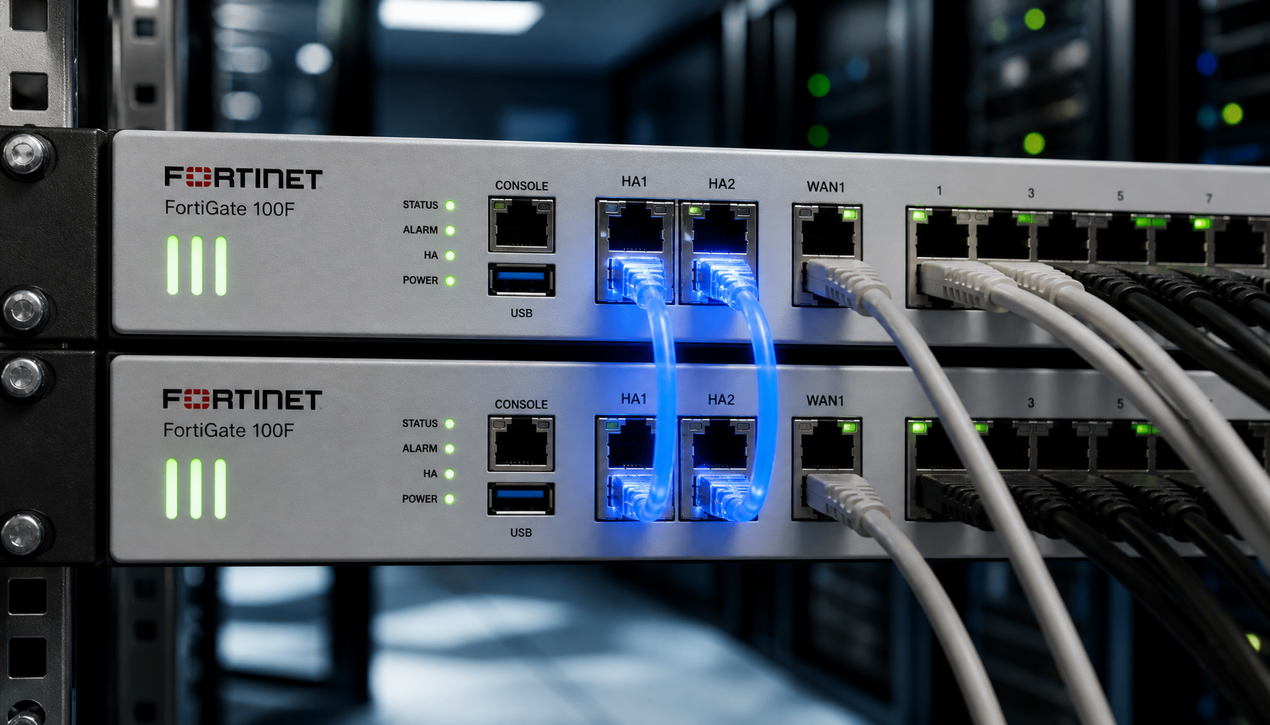
یک پورت فیزیکی خالی (مثلاً Port3) را در هر دو دستگاه بهعنوان کانال همگامسازی انتخاب و مستقیماً با کابل یا از طریق یک سوئیچ ایزوله به هم متصل کنید. این Interface نیازی به IP از شبکه سازمانی ندارد؛ سوفوس بهصورت خودکار یک شبکه Link-Local بین دو گره برقرار میکند. این کانال مسئول انتقال سنگینترین بخش دادهها یعنی Session State Tables و تغییرات پیکربندی است.
برای حداکثر قابلیت اطمینان، یک پورت فیزیکی کاملاً مجزا (مثلاً Port4) برای Heartbeat در نظر بگیرید و دو پورت را مستقیماً به هم وصل کنید. این کانال تنها برای تبادل بستههای کوچک «من زندهام» (Keepalive) استفاده میشود. اگر سیگنالها روی تمامی کانالهای HA از دست برود، گره Secondary فرض خرابی کامل گره اصلی را کرده و Failover آغاز میشود. این جداسازی از بروز سناریوی خطرناک Split-Brain که در آن هر دو گره خود را فعال میپندارند، جلوگیری میکند.
در بخش پیکربندی High Availability کنسول، برای هر Zone آدرس Virtual IP مربوطه را وارد کنید. هنگام به دست گرفتن نقش فعال، گره جدید یک Gratuitous ARP پخش میکند تا سوئیچها و دستگاههای همجوار از انتقال MAC مربوط به VIP مطلع شوند و جدول MAC سوئیچها بهصورت خودکار بهروزرسانی شود.
نکته کلیدی این است که تمام سرویسهای ارائهشده توسط فایروال — شامل DHCP Server، VPNهای Site-to-Site و Remote Access و سرویسهای احراز هویت — باید روی VIPها تنظیم شوند، نه روی IPهای اختصاصی دستگاهها. در نهایت، با قطع فیزیکی لینک WAN یا LAN روی گره فعال، جابهجایی VIPها و صحت Failover را مشاهده و تأیید کنید.
اگر در طراحی این توپولوژی از بخش DMZ برای انتشار سرویسهای اینترنتی استفاده میکنید، مقاله طراحی DMZ امن با فایروال سوفوس مکمل مناسبی برای این مرحله است.
پس از استقرار اولیه، این تنظیمات به شما امکان میدهند رفتار خوشه را با نیازهای خاص شبکه خود تطبیق دهید.
این بخش «مغز تصمیمگیر» Failover است و تعیین میکند بر اساس کدام معیارها جابهجایی نقش آغاز شود. میتوانید Interfaceهای خاصی مانند WAN1 و WAN2 را تحت نظارت قرار دهید تا فایروال با ارسال پروبهای فعال (مانند Ping) به آدرسهای مقصد از پیش تعریفشده، سلامت لینک را بسنجد. تنظیم آستانه تعداد عدمپاسخ (مثلاً 3 بار شکست) در برابر نویز موقت شبکه مقاومت میکند.
سوفوس همچنین امکان تعریف شرایط ترکیبی
را میدهد؛ برای مثال میتوانید تعیین کنید Failover تنها در صورت از دست رفتن تمامی لینکهای WAN تحت نظارت رخ دهد (نه فقط یکی از آنها)، یا تنها زمانی که هم Heartbeat و هم یک لینک WAN حیاتی از دست رفته باشند. با مانیتور کردن همزمان چند مقصد در یک سگمنت، از Failover ناخواسته به دلیل خرابی تنها یک دستگاه مقصد جلوگیری میشود.
همگامسازی وضعیت بهطور پیشفرض فعال است، اما در سناریوهای خاص با اتصالات کوتاهمدت و انبوه میتوانید نوع Sessionهای همگامشونده را محدود کنید تا بار روی کانال Sync کاهش یابد. بافر همگامسازی (Sync Buffer) نیز بهصورت موقت دادهها را ذخیره میکند تا هیچ بهروزرسانی وضعیتی در لحظات تغییرات پرشمار از دست نرود. در محیطهایی با پهنایباند محدود بین گرهها، فعالسازی فشردهسازی حجم ترافیک Sync را کاهش میدهد، هرچند کمی بار پردازشی اضافه ایجاد میکند.
پروتکلهای حالتمندی مانند FTP، SIP و H.323 نیازمند همگامسازی دقیق وضعیتاند؛ سوفوس بهصورت پیشفرض مکانیزمهای Deep Inspection لازم برای استخراج این حالتها را دارد که باید از فعال بودن آنها اطمینان حاصل کنید. برای اتصالات VPN (بهویژه SSL VPN و IPsec) و جلسات پروکسی احراز هویت نیز باید از همگامسازی صحیح اطلاعات کاربر و پارامترهای تونل مطمئن شوید. توصیه عملی: پس از هر Failover، سلامت سرویسهای حساسی مانند VPN و تماسهای VoIP را بهصورت دستی تست کنید.
سوفوس دو حالت برای بازگشت نقش فعال به گره اصلی پس از رفع عیب ارائه میدهد. در حالت Automatic Failback، بهمحض تشخیص سلامت گره اصلی، نقش Active خودکار پس گرفته میشود که میتواند دو قطعی کوتاه (در Failover و Failback) ایجاد کند. در حالت Manual Failback — که توصیه میشود — اپراتور پس از اطمینان کامل از سلامت گره اصلی، بازگرداندن سرویس را بهصورت کنترلشده انجام میدهد.
هنگام اجرای Sophos Firewall بهصورت ماشین مجازی روی VMware vSphere، Hyper-V یا KVM، میتوان از HA سطح هایپروایزر بهعنوان مکمل استفاده کرد؛ هایپروایزر در برابر خرابی سرور فیزیکی محافظت میکند و HA نرمافزاری سوفوس Failover در سطح شبکه را مدیریت میکند. vNICهای کانالهای Sync و Heartbeat باید به پورتگروههایی متصل شوند که فقط بین دو VM قابل دسترسیاند، و برای vNICهایی که VIP روی آنها قرار میگیرد، یک MAC ثابت در هایپروایزر اختصاص دهید تا از مشکلات ARP پس از جابهجایی VM جلوگیری شود.
رزرو حداقلی CPU و حافظه برای هر VM نیز از افت عملکرد ناشی از رقابت بر سر منابع — که ممکن است بهاشتباه خرابی تفسیر شود — جلوگیری میکند.
پیادهسازی خوشه تنها آغاز راه است؛ اطمینان از عملکرد صحیح آن در لحظه بحران، مستلزم اجرای منظم تستها و پایش مستمر است. تمام تستهای زیر باید در پنجرههای تعمیرات و با اطلاع قبلی انجام شوند.
در محیط تست و با دسترسی SSH به کنسول دستگاه، میتوان وضعیت خوشه را بررسی و از دستورات کمکی مخصوص HA برای عیبیابی استفاده کرد. این دستورات باید فقط در محیط آزمایشی یا با هماهنگی مدیر سیستم اجرا شوند. در سادهترین شکل، ورود به CLI و فراخوانی منوی_help وضعیت HA چنین شکلی دارد:
از آنجا که نام دقیق پارامترها بسته به نسخه SFOS متفاوت است، برای مشاهذه فهرست کامل دستورات مجاز در نسخه خود، از فراخوانی help در پوسته استفاده کنید:
در کنسول تحت وب مسیر System > High Availability
وضعیت کلی خوشه شامل نقش فعلی دستگاه، وضعیت Sync (باید Up باشد)، وضعیت سلامت گره مقابل و آمار ترافیک کانال Sync نمایش داده میشود. علاوه بر آن، پایش مصرف CPU، حافظه و دمای هر دو گره از طریق SNMP حیاتی است؛ تخلیه حافظه یا دمای بالا معمولاً پیشدرآمد یک خرابی است. میتوان OIDهای مرتبط با HA را در سیستمهای نظارتی مانند Zabbix یا PRTG برای ارسال هشدار فوری تعریف کرد.
نکته تکمیلی: پایش سرویسهای حیاتی از بیرون شبکه (مانند دسترسپذیری وبسرور عمومی) نمای کاملی از عملکرد کل زنجیره شامل HA ارائه میدهد.
در بخش Log & Report > System Logs
با فیلتر روی System Services و زیرمجموعه High Availability، رویدادهای کلیدی قابل ردیابیاند؛ از جمله تغییر نقش گرهها (ACTIVE/PASSIVE)، شروع Failover همراه با دلیل آن (مثلاً Heartbeat timeout یا Down شدن یک Interface)، تغییر وضعیت همگامسازی به UP/DOWN، فراهم شدن یا رفع شرایط Failover و هشدار بحرانی Split-Brain که نیازمند مداخله فوری است. نکته طلایی: همیشه پس از هر Failover یا راهاندازی مجدد، لاگهای HA را با دقت مرور کنید.
از طریق SSH میتوان از دستوراتی مانند نمایش وضعیت خوشه، بررسی جزئیات کانال همگامسازی و برداشت بسته روی Interfaceهای Sync و Heartbeat برای تأیید تبادل صحیح بستههای کنترل استفاده کرد. ابزارهای عمومی مانند ping و traceroute از داخل CLI فایروال نیز برای تست دسترسی به Targetهای Link Monitoring و تشخیص مشکلات مسیریابی کاربرد دارند. علاوه بر این،
Support Tool سوفوس (از مسیر Administration > Support) یک فایل تشخیصی جامع شامل تنظیمات، لاگها و وضعیت Sessionها تولید میکند که تحلیل آن معمولاً سریعترین راه حل مشکل است.
تنظیمات High Availability در فایروال سوفوس با خوشه Active-Passive، همگامسازی وضعیت اتصالات و مدیریت هوشمند VIP، تداوم سرویس را حتی در زمان خرابی سختافزاری تضمین میکند. موفقیت در این استقرار به سه عامل وابسته است: رعایت دقیق پیشنیازها (سختافزار و نسخه یکسان)، پیکربندی صحیح کانالهای Sync و Heartbeat، و اجرای منظم تستهای Failover در پنجرههای تعمیرات. اگر قصد مقایسه راهکارهای مختلف پیش از تصمیم خرید دارید، صفحه
قیمت فایروال فورتی گیت نیز برای ارزیابی گزینههای رقیب مفید است. برای حفظ یکپارچگی امنیتی لایههای بالایی مانند انتشار امن سرویسهای وب، رعایت اصول راهنمای رسمی OWASP برای ارزیابی امنیت برنامههای وب نیز توصیه میشود.
خیر. تشکیل یک خوشه پایدار مستلزم این است که هر دو گره از یک مدل سختافزاری با مشخصات مشابه باشند. اختلاف در پردازنده، حافظه یا پورتها میتواند به ناسازگاری در پردازش اتصالات و رفتار غیرقابل پیشبینی خوشه منجر شود.
بسته به تنظیمات Timeout و شرایط تعیینشده، Failover معمولاً در کسری از ثانیه تا چند ثانیه انجام میشود. به لطف Stateful Synchronization، گره جدید دقیقاً از همان نقطهای که گره قبلی متوقف شده ادامه میدهد و کاربران نهایی معمولاً هیچ وقفهای حس نمیکنند.
در Failback خودکار، بهمحض تشخیص سلامت گره اصلی، نقش Active خودکار به آن بازگردانده میشود که میتواند دومین قطعی کوتاه را ایجاد کند. در Failback دستی که توصیه میشود، اپراتور پس از اطمینان کامل از سلامت گره اصلی و در زمان مناسب، بازگرداندن سرویس را کنترلشده انجام میدهد.
در مدلهای سادهتر این ترکیب ممکن است، اما توصیه نمیشود. استفاده از دو پورت فیزیکی مجزا احتمال تشخیص اشتباه خرابی گره اصلی را کاهش میدهد و لایه محافظتی در برابر سناریوی Split-Brain ایجاد میکند. اتصال مستقیم این پورتها به یکدیگر (یا از طریق یک سوئیچ ایزوله) بهترین روش است.